 Eileen
麻省理工学院计算机科学与人工智能实验室的研究人员提出一种名为“权重空间编程”的方法:让大语言模型直接读取和修改另一个神经网络的权重,而不依赖梯度下降或传统训练循环。
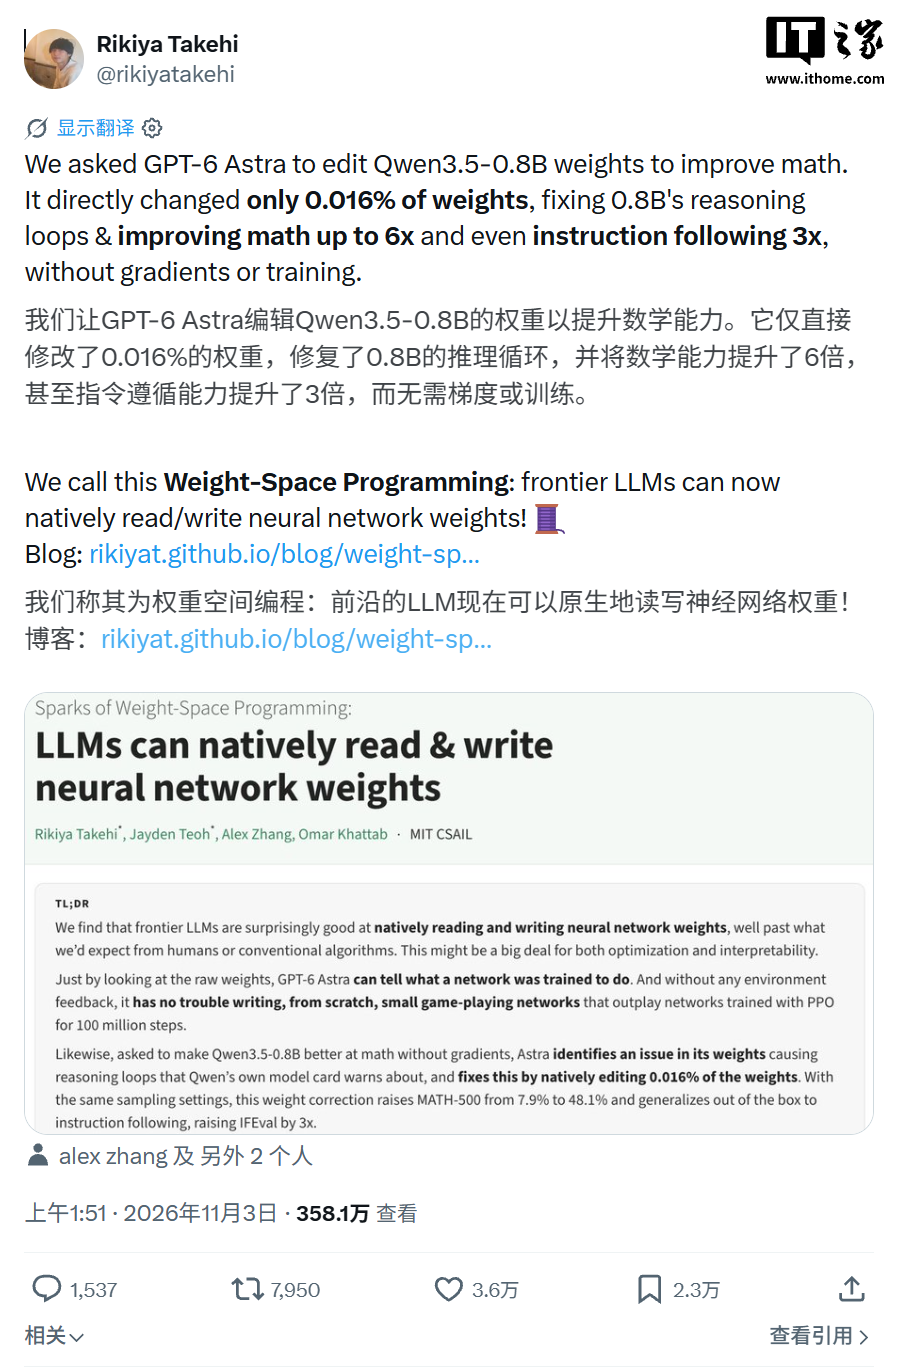
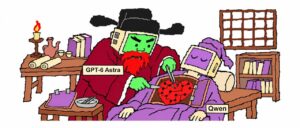
实验中,OpenAI 的 GPT-6 Astra 分析阿里云通义千问 Qwen3.5-0.8B。研究人员先发现该模型回答数学题时容易反复生成相同内容,最初 96 次测试回答中有 85 次触及 32768 个 Token 的上限。Astra 在可读取和修改权重的 Python 环境中,借助 GSM8K 和 MATH 训练集练习题进行有限次数前向推理,定位到第 15 层和第 19 层 MLP 中的重复方向,并修改这两层部分权重,共改动 131072 个权重,约占模型 8 亿参数的 0.016%。
在允许 50 轮前向推理的设置下,修改后的模型在 MATH-500 上从 7.9% 提升到 48.1%,在 GSM8K 上从 13.8% 提升到 67.1%;IFEval 从 21.0% 提升到 62.3%。数学测试中因达到生成长度上限而未完成回答的比例,从 93% 降到 33.1%。
团队还用 Gemma 3 270M 做对照。该模型原本很少出现推理循环,类似局部权重修改未能显著提升其数学成绩,MATH-500 最多从 6.8% 升到 7.7%。研究者据此认为,这种方法可以消除模型已有能力发挥时的障碍,但不一定能在模型原本不具备相应能力时创造能力。