 miranda
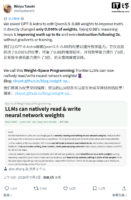
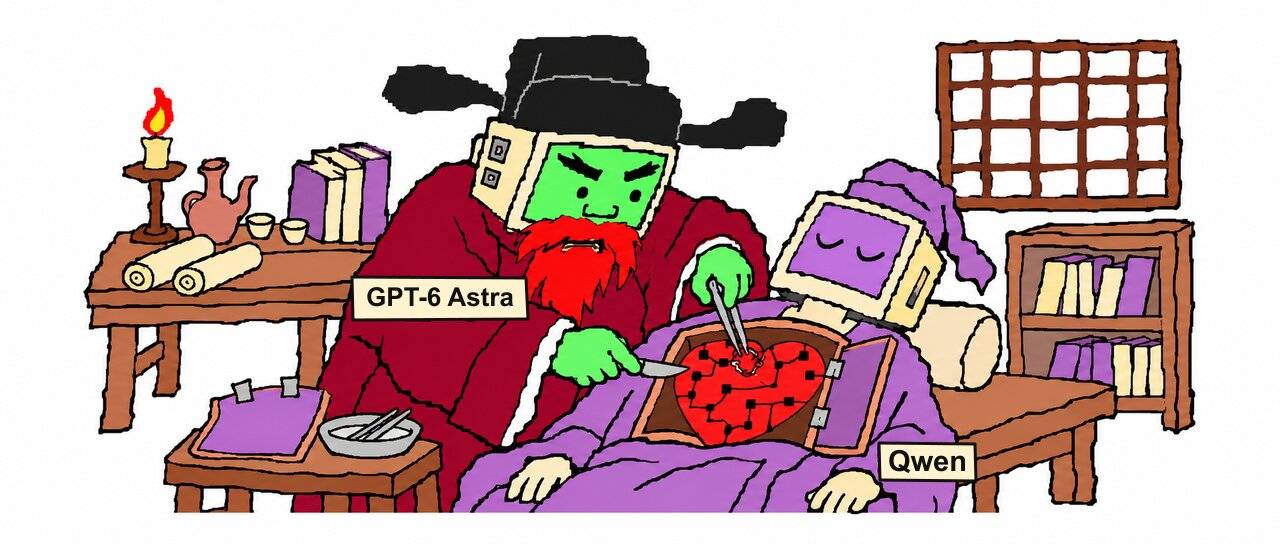
MIT CSAIL 的研究团队展示了一项实验:让 GPT-6 Astra 直接读取并修改另一个模型的权重。实验对象是 8 亿参数的 Qwen3.5-0.8B,Astra 只改动了其中 131072 个参数,约占总量的 0.016%。结果显示,该模型在 MATH-500 上的成绩从 7.9% 升到 48.1%,GSM8K 从 13.8% 升到 67.1%,指令遵循能力也有改善。整个过程没有使用梯度训练。团队将这种方法称为「权重空间编程」(Weight-Space Programming)。
不重新训练,直接改数值
权重可以理解为神经网络计算时使用的大量数值,训练在相当程度上就是不断调整这些数值。以往大模型参与模型迭代,多集中在编写训练代码、调整超参数、设计训练流程等环节,千亿乃至万亿级的权重本身仍由优化算法更新。权重空间编程把对象换成了权重本身:让通用大模型按照自然语言目标读取和修改网络参数,在某些实验中甚至不需要环境反馈。
先读懂,再改写
为验证模型能否读懂权重,团队做了几组测试:Astra 仅凭权重,就能判断几个结构相同的小网络分别针对哪款游戏优化,也能判断扩散模型会生成圆形、方形还是三角形;面对小型语言模型,它只看中间层权重就能判断训练语料是 Python、英文还是日文罗马字,并找出负责复制前文的注意力头。在写权重方面,一个用 PPO 训练约 10 亿步的小车控制网络,在 256 局检查中一次都没有成功;Astra 修改了 3.5% 的权重,加入「先后退蓄力、再全速前进」的控制路径后,成功率变为 100%。它还能依据游戏规则从零生成网络权重,生成的网络在三个 MinAtar 游戏中超过了训练 1 亿步的 PPO 网络;在 9×9 围棋任务中,经过有限的前向测试和修改,也超过了同规模、训练 2000 万局的 PPO 网络。
讨论中也出现了质疑:Qwen 本身存在严重的重复推理问题,数学成绩的大幅提升,可能主要来自这个缺陷被修好,而不代表模型凭空获得了新的数学能力。