 Eileen
Agent改变了使用平台的方式。工程师提交数据处理代码,往往要等十几分钟甚至几十分钟才能看到结果、改代码、再提交。Agent没有这段空隙:拿到结果就立刻验证,并发尝试其他方案,很快进入下一轮调用。人交给平台的是相对确定的任务,算完就走;Agent会不断换方法完成同一个目标,管控压力和隐形计算压力因此被放大,成为云计算需要面对的新负载。
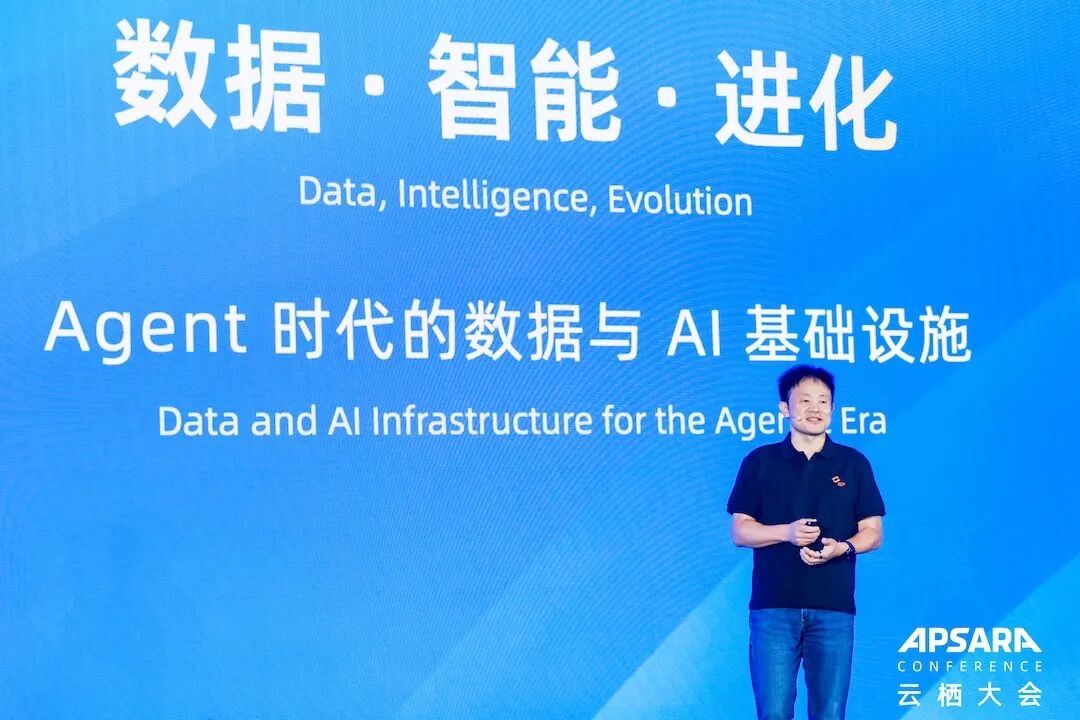
模型长成Agent后,不再只是等待调用的接口,而更像会自己找数据、拆任务、并发试错的数字员工。阿里云李飞飞在云栖大会上把智能体落地拆成三个词:Model决定智能上限,Context决定Agent能否读懂业务,Harness决定它能否调起工具、把事做完并持续运行。数据产生智能,智能以Agent形态进入业务,业务又产生新数据和新负载。飞轮的快慢取决于模型生产、智能落地和系统自我进化三方面的效率。
进入物理世界后,数据先成为瓶颈。自动驾驶、具身智能和科学计算面对的是视频、点云、运动轨迹和传感信号。穹彻智能吕峻提到,具身智能数据从采集到进入训练可能经过几十道处理,一次数据版本迭代短则两周,长则一个月。长期看,可用数据规模可能仍有两到三个数量级缺口,现阶段更直接的问题是数据质量:哪些数据有效,如何精细标注与质检,算法能否把数据转化为模型能力。模型辅助标注可加快迭代,把人力集中到质检和高难度样本上。
围绕数据到训练、推理再到系统自优化的链路,阿里云在云栖大会上做了升级。MaxCompute将CPU、GPU和大模型Token纳入统一调度,MaxFrame和SQL AI Function可调用模型处理图片、文本等全模态数据;行业Skill封装数据管线,开发者可用自然语言组织任务。EMR Serverless Spark支持Spark、Ray、Daft等引擎,并连接Paimon、Iceberg。按阿里云公布的数据,具身智能数据处理耗时减少40%,PB级原始数据可直接生成LeRobot、RLDS格式训练集。训练端PAI-DLC 3.0引入Xfuse,联合分析算力底座、训练框架和任务运行状态,自动定位通信、数据读取、算子和资源调度问题,多模态模型端到端训练速度提升2.4倍。这些优化依赖芯片、云平台与模型的协同,也就是阿里云强调的“芯云模一体”。