 miranda
Agent应用变多后,大模型行业的关注点正在从“谁又刷新了能力上限”转向“能不能长期用得起”。原文提到,2026年Agent流行起来,任务往往需要几十轮模型调用,读材料、查代码、调用工具和处理报错都会增加上下文与调用次数。OpenRouter披露,2月6日平台上Agent的Token用量首次超过人类直接调用,到9月底约为后者的七倍。
成本压力在具体任务中更明显。密歇根大学与斯坦福大学4月一项覆盖8款模型、500个真实代码问题的研究显示,Agent每次尝试处理一个问题,平均累计消耗约417万Token,模型调用费约1.86美元;连续跑十次接近20美元。任务越长,速度和价格就越受关注,Flash类模型因此获得更多使用场景。
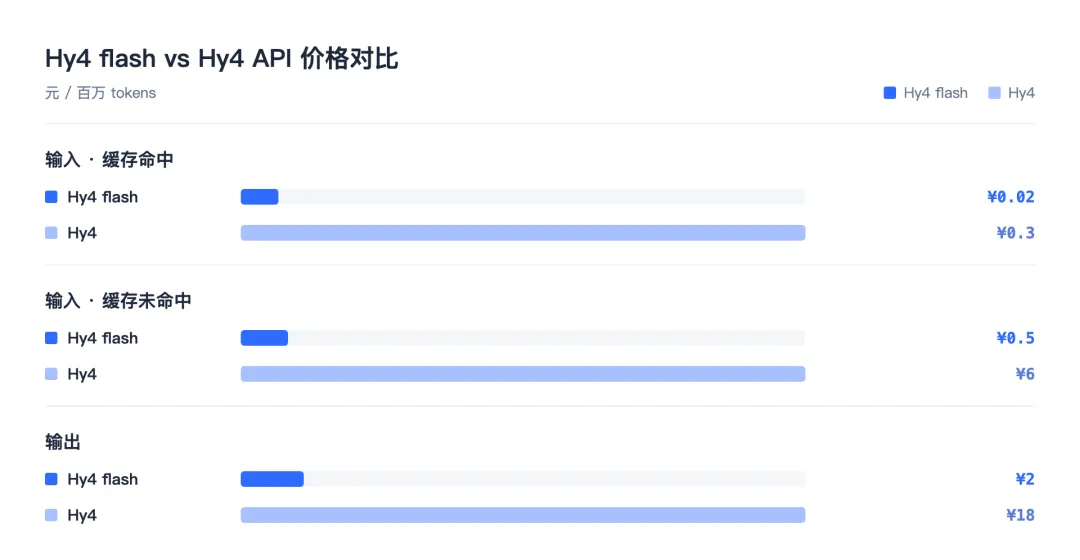
腾讯近期推出的Hy4 flash是其中一个受关注的模型。原文信息显示,其总参数量为224B,其中64B为Engram参数;预训练阶段加入混合注意力、LatentMoE、Engram等架构,实际激活参数为12B,KV cache大小为Hy3的1/24、Hy4的1/6,并支持多模态和1M上下文。价格方面,每百万Token输入0.5元、输出2元,命中缓存为0.02元,较Hy4明显降低。
后训练阶段,Hy4 flash通过自蒸馏Hy4获得综合智能水平,并用强化学习把端到端任务输出长度降低50%,单任务成本为Hy4的二十分之一。推理侧结合megakernel、4bit量化和DFly后,解码速度超过150 tps。原文作者在WorkBuddy中免费使用Hy4 flash,与DeepSeek-V4.1-Flash(1017版本)和原始Hy4做了办公决策、编程修复、视觉理解、PPT生成四轮对照;首轮办公决策结果显示判断一致,Hy4 flash快了近三分钟。