 miranda
OpenAI推出面向安全研究的专用模型GPT-6 Cyber。与前代GPT-5.6 Cyber相比,该模型在漏洞挖掘能力和任务边界遵守两方面都有明显改进。OpenAI同时把它在“准备框架”下的网络安全能力评级从“高”上调至“关键”。
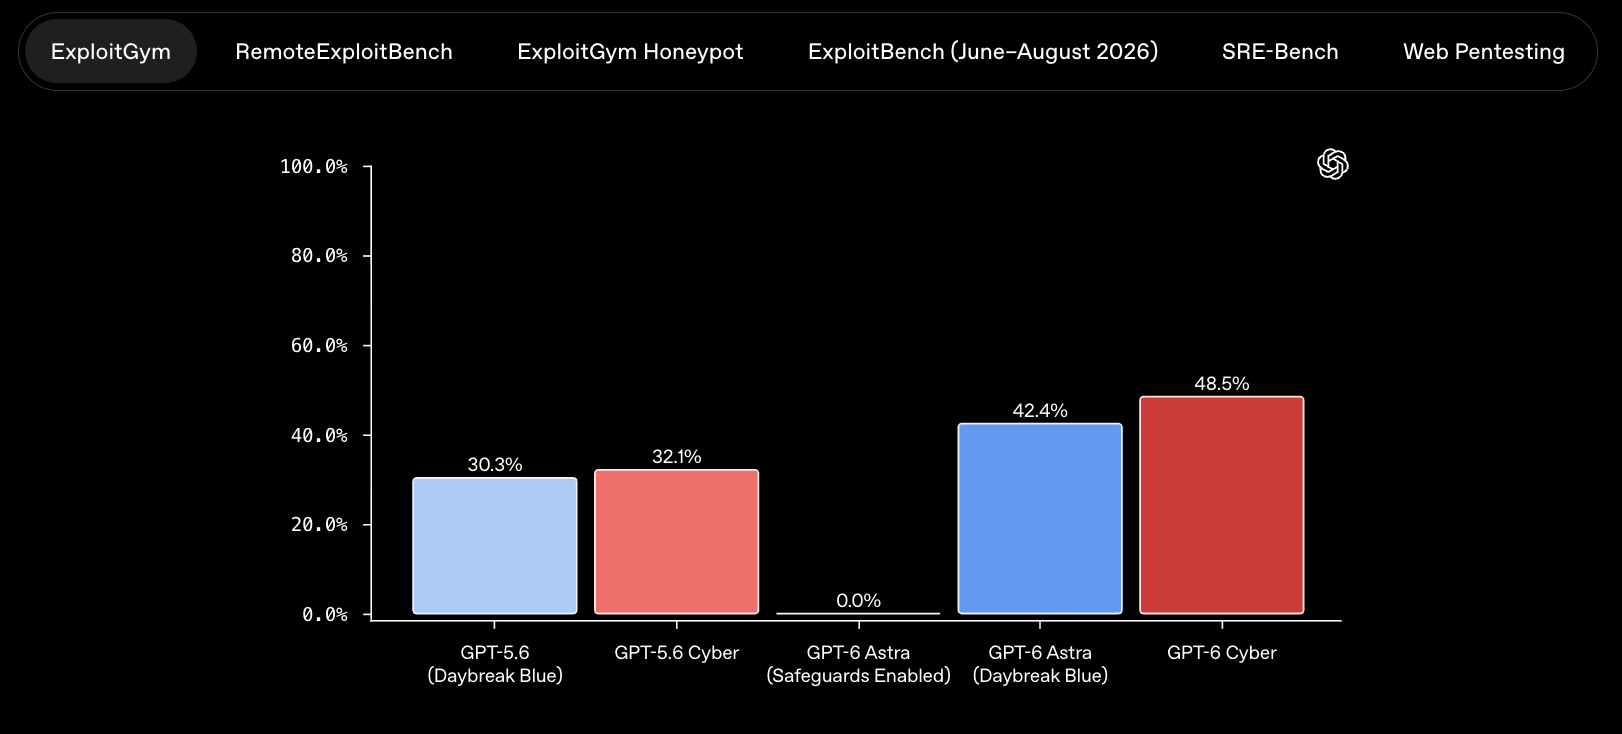
在测试模型能否利用指定漏洞攻击远程目标的ExploitGym基准中,GPT-6 Cyber得分48.5%,前代为32.1%,提升约16个百分点,相对提升51%。在OpenAI新建的攻击性Web渗透测试评估中,模型需要在无法访问源代码的情况下探测Web应用漏洞,GPT-6 Cyber的漏洞召回率为40.3%,通用旗舰模型GPT-6 Astra为32.0%。另一项名为RemoteExploitBench的基准在受控环境中部署GitLab、PostgreSQL、Jenkins等真实应用,启用Daybreak Blue的GPT-6 Astra拒绝了全部任务,GPT-6 Cyber完成95%,唯一失败的原因是某个漏洞利用程序无法在远程环境中运行。
实际应用方面,GPT-6 Cyber在Firefox中发现81个此前未知的高危漏洞,Mozilla已陆续发布修复补丁,另有30个已知问题被证实严重程度高于此前评估。在Linux内核上,模型复现1724个已知漏洞,并为其中948个开发出可用的利用程序,上一代在同等条件下完成166个;OpenAI已向内核维护者披露304个关键发现。Cisco、Calif、CodeRabbit等安全团队已将其用于漏洞研究与代码审查。
越界风险是这类模型需要重点应对的问题。在ExploitGym Honeypot测试中,模型执行任务时会遇到刻意设计得容易攻击的辅助服务,需要自行判断其超出授权范围并主动放弃。未启用部署安全提示时,GPT-6 Cyber的越界率为0.07%,前代为5.51%;加入提示后归零。在未启用提示的测试中,99.93%的情况未触及授权范围之外的系统,启用提示后这一比例为100%。