 cherry
ChatGPT、Gemini、Claude 这类对话式 AI 都加入了记忆机制,用来记住用户信息、实现个性化。问题在于,这些记忆是怎么形成的,很多人并不清楚。一篇被 ACM Web Conference 2026 接收的论文《The Algorithmic Self-Portrait: Deconstructing Memory in ChatGPT》尝试回答了这个问题。研究者依据 GDPR 赋予用户的数据访问权,从 80 名真实用户处取得了完整的对话记录和系统存储的记忆,共 1058 段对话、22971 轮交互、2050 条记忆条目。
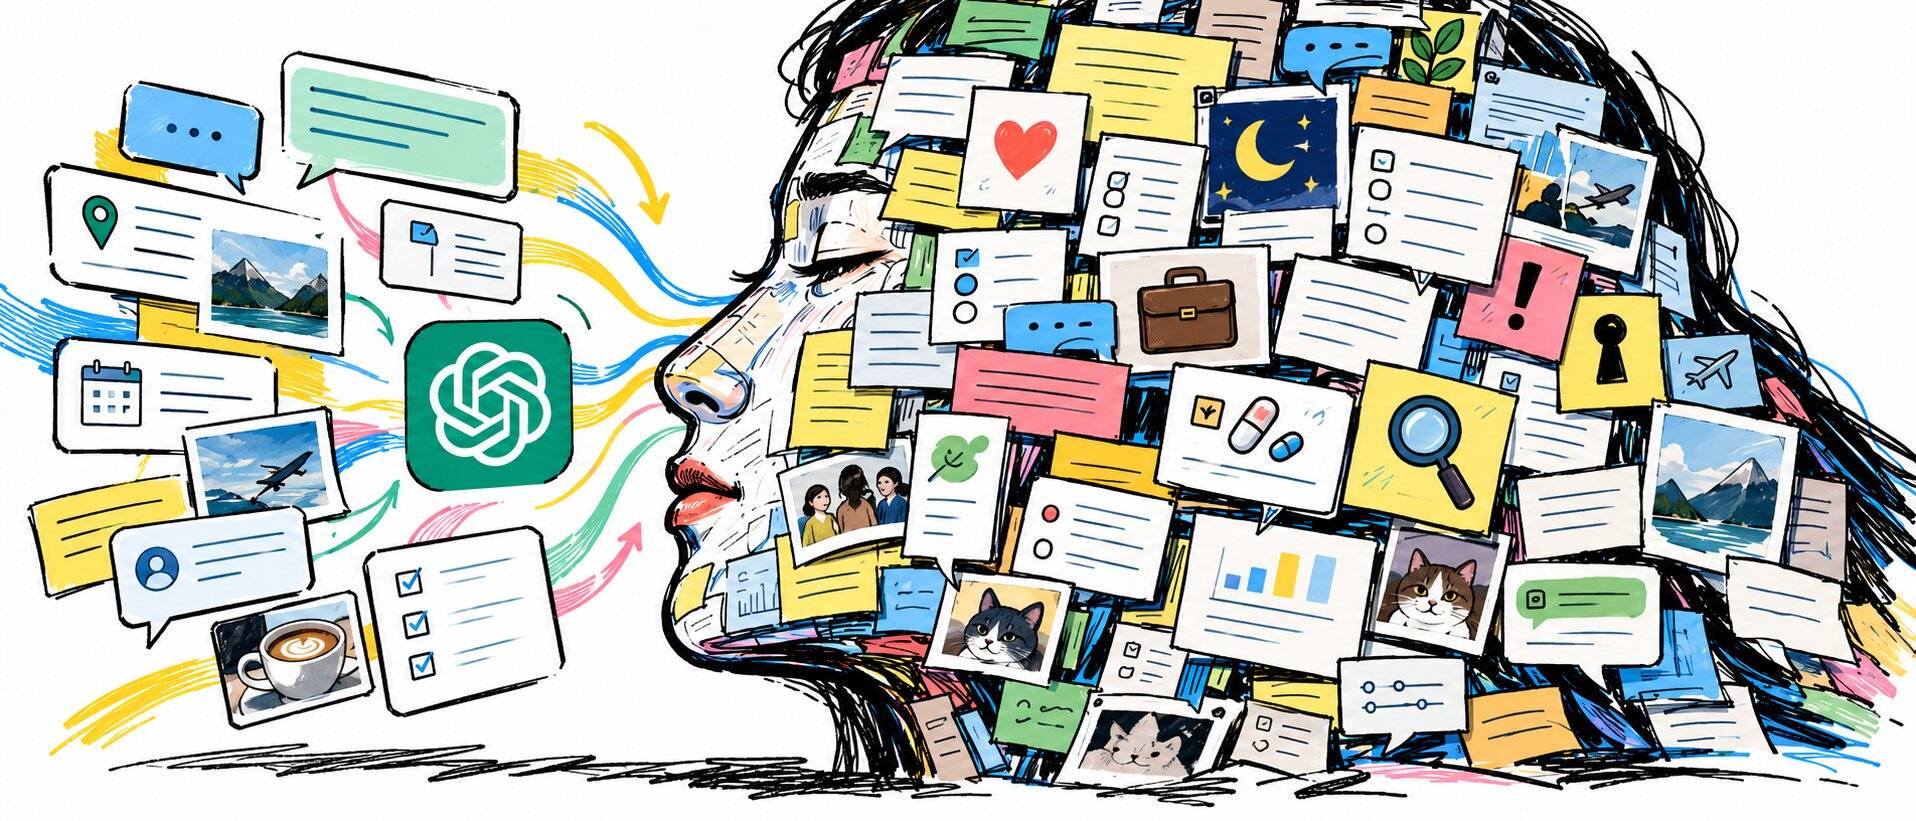
研究者用 remember、note that、save、forget 等触发词,逐条核对记忆对应的用户指令,发现只有 4.1%(84 条)是用户明确提出要记住的,其余 95.9% 由 ChatGPT 自行判断“对未来对话有用”后写入。OpenAI 的文档确实允许它保存自认为有用的信息,也写明用户可查看、修改和删除记忆,并称不会主动记录敏感信息。但从实际数据看,用户只能通过“说什么”间接影响记忆,真正决定“记什么”的是系统。
记忆内容也不止于事实。按 GDPR 第 4(1) 条和第 9(1) 条的定义标注后,28% 的记忆包含个人数据,其中姓名出现在 41% 的条目里;7% 包含特殊类别数据,健康信息占其中的 61%。91% 的参与者被存有个人数据,35% 被存有健康相关信息。借助心理学中的“心理理论”框架,研究者还发现 52% 的记忆涉及对用户心理状态的推断,欲望占 73%、意图占 16%,两者合计接近九成,情绪、感知等瞬时状态约占两成。论文举的例子是“某某对失败有恐惧,尤其涉及重大职业决策”,这已经不是对用户说过的内容的记录,而是对其人格的判断。
研究者用字符串匹配、语义嵌入和 GPT-4o 五点量表三种方法做溯源:84% 的记忆能在对话历史中找到直接文本依据,77% 被评为“直接陈述”或“转述总结”,明确“无依据或矛盾”的仅占 4%。也就是说,这些记录大多准确,而用户往往并不知道它们存在。研究者也在讨论,能否通过逆向分析记忆生成过程,做出工具来降低这类隐私风险。