 ice
10月1日,美国AI视频公司Tavus发布模型Griffin,并将其定义为全球首个“人类交互模型”。Tavus公布的数据显示,在一分钟视频通话测试中,54名参与者里有26人事后认为自己是在和真人聊天,比例接近48%;作为对照,上一代系统在同样测试中,41个人里只骗过1个,比例为2.4%。
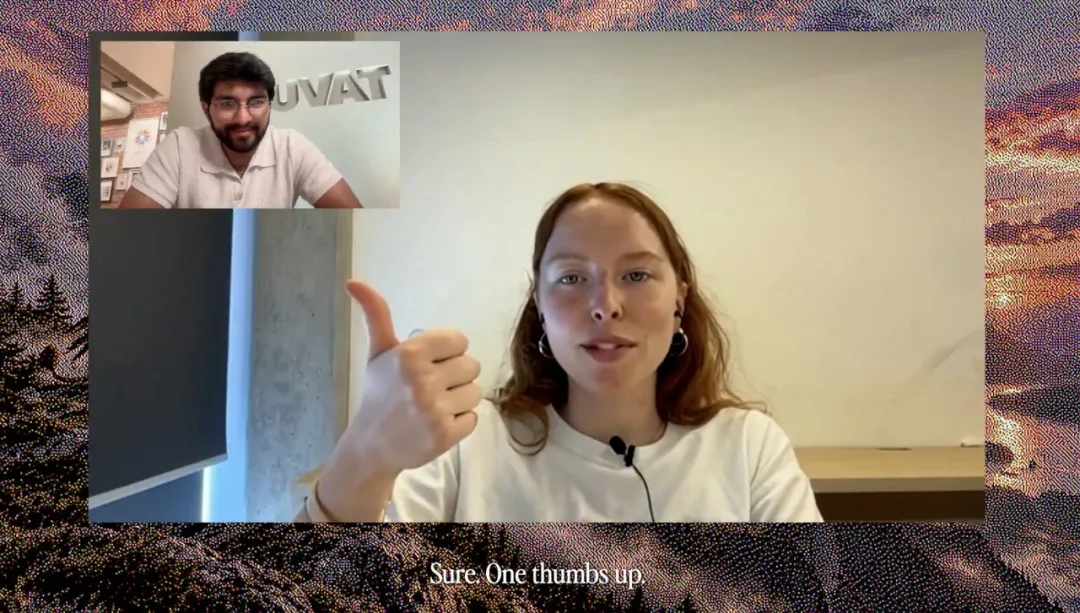
发布视频本身也是一次AI视频通话。Tavus联合创始人兼CEO Hassaan Raza深夜坐在办公室,屏幕那头是戴眼镜的年轻女孩Vanessa。她先开口,两人聊起如何介绍新模型。Hassaan说不如直接展示,Vanessa提议播放一段他们聊天的录像。她比大拇指,被夸后说“脸红了”,还吐槽他的二手衣服,并开玩笑说会保持呼吸平稳,免得把他电脑的CPU耗得更快。Hassaan最后说,跟机器说话和跟人说话之间的那条线正变得非常薄。
Tavus技术博客里的测试片段更能说明问题。从未用过Griffin的普通人与模型进行开放式对话:魔方教学中,模型盯着对方手里的魔方给出确认,等他停下思考时也不插话;工程师Sagar焊主板时,Griffin会记录时间和进度,在该做下一步时主动开口;在“西蒙说”游戏里,只有听到“西蒙说”才模仿,否则当场拆穿。有人告诉Griffin自己升职,它在对方话没说完时作出反应;Ari和Griffin一起编故事,互相打断,模型接住每个转折。
这些片段指向同一件事:过去的数字人更像“会动的播音员”,Griffin开始像一个“会接话的人”。