 ice
TypeSafe推出的新AI模型Jev最近受到关注。它不写长答案,只做选择、评分和是非判断。随着大模型进入更长的工作流,很多步骤不需要重新生成内容,只要决定下一步。据Vercel数据,Jev上线第一天,每100个付费团队中约有13个调用它,首日调用团队数超过此前新模型纪录的两倍。随后,Cloudflare提供调用入口,LangChain和Langfuse也相继跟进。
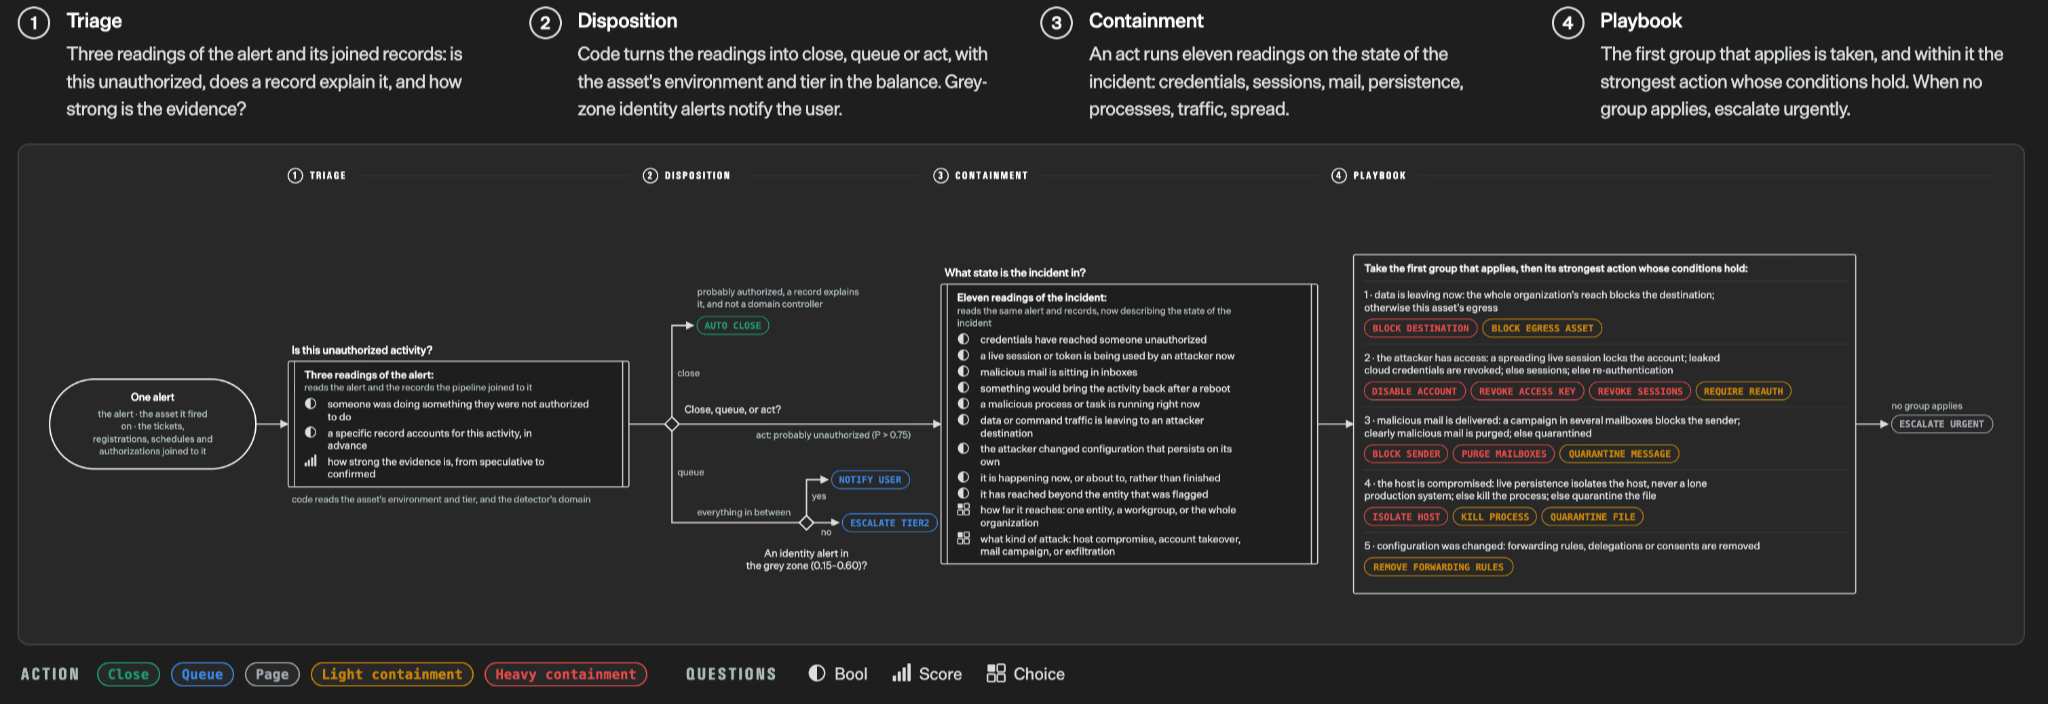
开发者可以把Jev放在大模型前后:任务开始前,它判断该调用哪个工具或模型;大模型给出结果后,它检查答案是否合格、流程是否继续。复杂推理和生成仍交给大模型,Jev接走那些规则写不完、又不值得每次调用大模型的小判断。TypeSafe称这类产品为“System One”模型。开发者预先写好问题、选项和返回格式,程序拿到结果后直接进入下一步。官方价格是每百万输入Token 0.042美元,输出不收费;端到端延迟70至500毫秒。它更像一条听得懂自然语言的if/else。
便宜、快,不等于什么都该交给它。TypeSafe列出的已知局限包括计数、数值运算和日期比较。代码能算清的金额、时间和数量,仍应留给代码;Jev适合“这条反馈更像投诉还是咨询”“这个操作是否可疑”“两件商品是不是同一款”之类的语义判断。TypeSafe自测称,Jev最高可把速度提高193.6倍,成本降到对照模型的0.3%以下,但这不是独立基准。
Jev把概率作为产品的一部分,能否配合还取决于它报出的把握是否可靠。开发者Charly Poly用Banking77做意图分类测试,该数据包含77类银行业务,如银行卡被吞、转账失败和修改个人信息。据其公开测试帖,Jev的宏平均F1为0.782,高于ModernBERT的0.712;托管环境中位延迟为299毫秒。把自动处理目标精度固定在90%后,Jev可接下67.5%的样本,ModernBERT为35.7%。但Jev声称有80%至95%把握的样本,实际正确率只有64%;另有6.6%的样本,正确标签被它打成零概率,ECE指标也落后于ModernBERT。GitHub项目jevcal用1600条Civil Comments判断结果做校准测试,校准后Jev的Brier分数从0.0837降至0.0248,AUC仍为0.9264。调整没有让它更会选答案,只是重新标定概率刻度,且该项目验证的是校准方法,并非Banking77中的零概率问题。