 Eileen
视频生成模型这一年进步明显,AI 短剧、换脸、场景合成在平台上越来越常见。但要得到一条满意的视频,仍需要反复生成、反复筛选,算力和时间成本都不低;真正接入专业影视流程时,现有模型能承担的工业级工作也还有限。面对这个问题,行业大致有两条路:一条继续堆参数、扩算力,等待通用大模型跨过工业门槛;另一条走进真实片场,从具体需求出发自下而上生长。达瓦科技选的是后者。
达瓦科技总部在重庆永川,团队从 2014 年起运营科技影视片场,2023 年成立达瓦科技并转向 AI 模型,今年先后完成 Pre-A 轮和 A 轮融资,累计融资约 5 亿元人民币。公司 CTO 朱子威把架构分成两层:渲染层像相机,负责把画面拍出来;控制层像导演,决定场景里有哪些物体、演员怎么走位、道具如何交互、时序怎样变化。达瓦自研的控制层基座模型叫 Latent Stage,先完成对人物、动作、镜头、灯光和场景的理解与控制,再交给渲染层出画面。这条路线被概括为「重控制、轻渲染」。
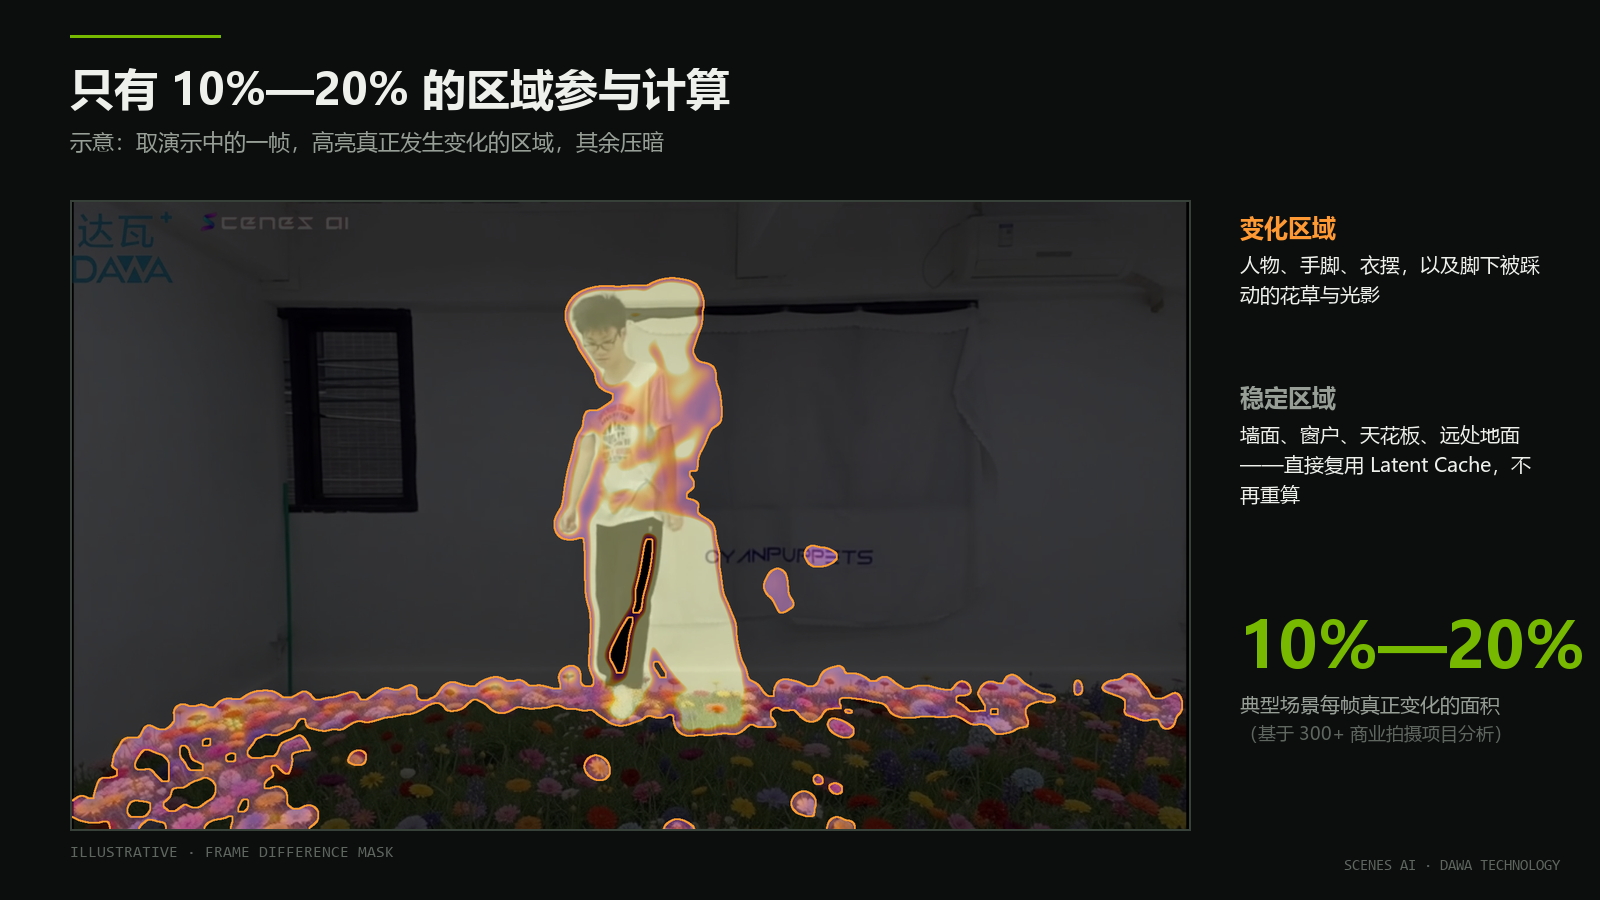
产品也围绕这条路线展开。FilmOS 面向专业内容团队做离线生成,输入一句话的目标即可产出画面,借助控制模型减少反复生成;Scenes AI 是正在研发的实时世界模型,基于稀疏扩散自回归架构,能在单张消费级显卡上运行,对摄像头画面进行实时演化和编辑。首席产品官李宗兴提到,片场经常向技术团队提出真实问题,比如导演只想改动画面中的一小部分,为什么要把整个镜头重拍,能否保留人物和动作、只改其余部分。
支撑这套做法的是片场积累的数据。达瓦在真实拍摄中沉淀了约 180TB 的结构化「过程数据」,记录的不只是成片,还包括从剧本、机位、灯光到动作捕捉的完整过程。朱子威还区分了 Agent 与控制层的不同作用:Agent 补的是信息差,帮不熟悉提示词和镜头术语的人接近模型上限;控制层处理的是认知差,即模型能否理解一个完整的物理片场,从而避免人物走位、道具位置在生成中错乱。