 ice
美国当地时间10月27日,谷歌DeepMind发布新一代世界模型Genie 4的研究预览。与此前用户进入AI生成场景探索相比,这次演示加入了原生音频:风声、水声、音乐可与画面一起生成,场景中的人物也能根据用户输入和眼前发生的事开口回应。
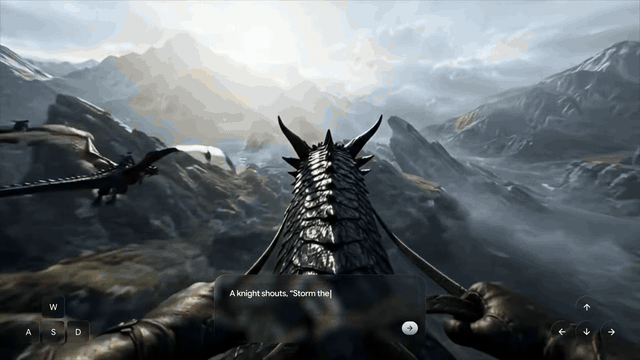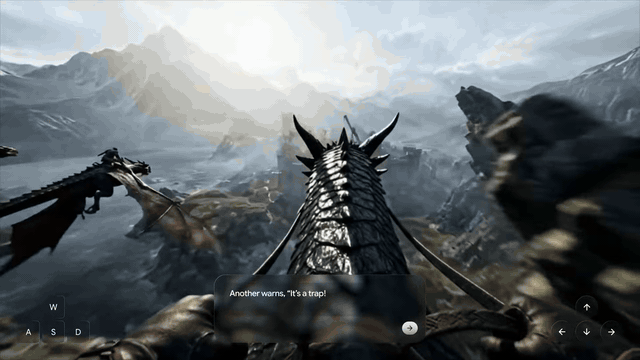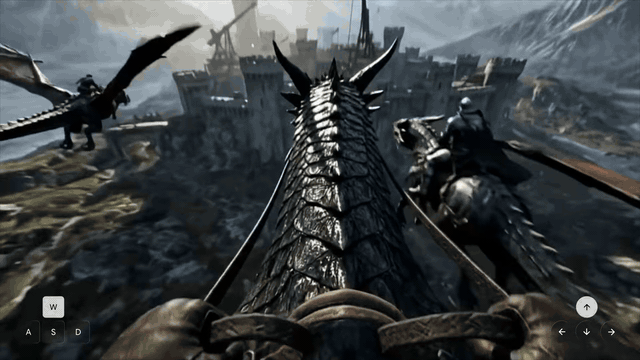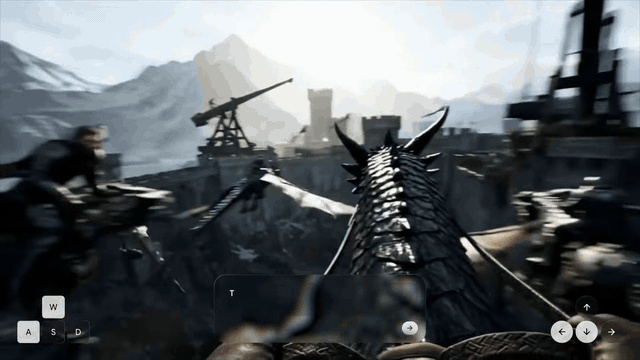
演示中,用户可以骑龙掠过山谷,以骑手视角控制飞行方向;也可以在湖上平台听萨克斯演奏,并输入文字让鲸鱼尾巴从演奏者身后的水面慢慢露出,同时保持原有的胶片质感。另一段演示把视角放在南极热气球吊篮中。操作方式相近:用按键决定移动和朝向,用文字补充希望发生的事,模型继续生成后续画面,而不是播放一段固定视频。
谷歌介绍,Genie 4能同时生成环境音、背景音乐和角色对白,对白不是提前配好的固定台词。用户改变情节时,人物可顺着新情况接话。电影创作者也在尝试用它做拍摄预演,先在同一场戏里换机位、改台词,再决定怎么拍。
“边玩边改”并非首次出现。2025年8月发布的Genie 3已展示过用文字改变天气、加入物体或人物的能力;今年1月推出的Project Genie原型尚未包含这项功能。Genie 4的推进在于让这些临时变化带上声音和人物反应。目前该模型只向少量受邀测试者开放,谷歌计划随后通过Project Genie向Google AI Ultra订阅用户提供,具体日期尚未公布。