 Eileen
特斯拉公布了更新后的 AI 加速器路线图,披露了未来几代芯片的研发方向。按路线图,第六代推理加速器 SI6 的算力预计达到现有第四代芯片 HW4(SI4)的 80 倍;用于训练任务的 Dojo D3 则不再以 SRAM 为核心,改为多芯粒设计,并采用堆叠式 HBM 高带宽内存。
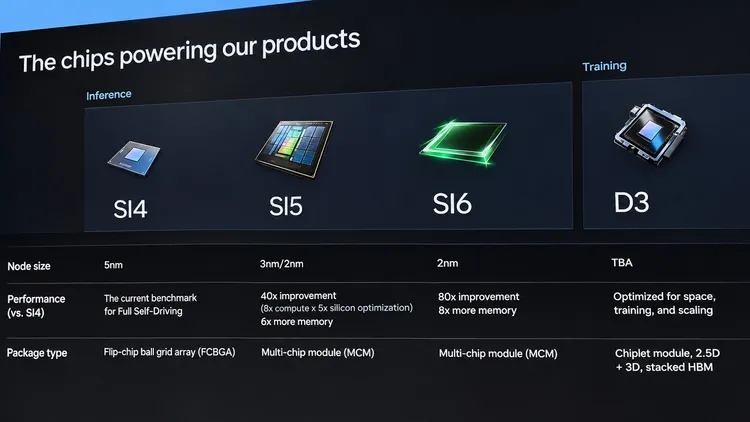
命名上,特斯拉用“超级智能”(Super Intelligence,SI)取代“人工智能”(AI),AI 加速器也随之启用 SI 系列命名。按其规划,HW3 已淘汰,SI4 已量产,SI5 接近量产,SI6 仍在研发中。
Dojo D3 换了思路
此次路线图中较受关注的变化,是特斯拉重启自研 Dojo 训练加速器项目。首代 Dojo D1 采用晶圆级系统(SoW)架构,依靠分布式片上 SRAM,每颗芯片 440MB、每片晶圆 11GB。D3 改用 2.5D 与 3D 封装并搭载堆叠式 HBM,指向的是更大的内存容量:现代 AI 模型在参数、激活值和中间数据上的内存开销,已不是 SRAM 容易承担的。
换用 HBM 便于扩展容量,但在延迟、带宽、封装和功耗上会带来不同取舍。特斯拉是否会彻底放弃晶圆级集成尚无定论:一种可能是仍在晶圆级互连的逻辑芯片上堆叠定制 HBM,另一种可能是认为晶圆级集成成本过高,只适合 SRAM 主导的架构。公司表示 D3 将面向太空、训练和扩展能力,具体算力、内存容量、制程与时间表尚未公布。