 ice
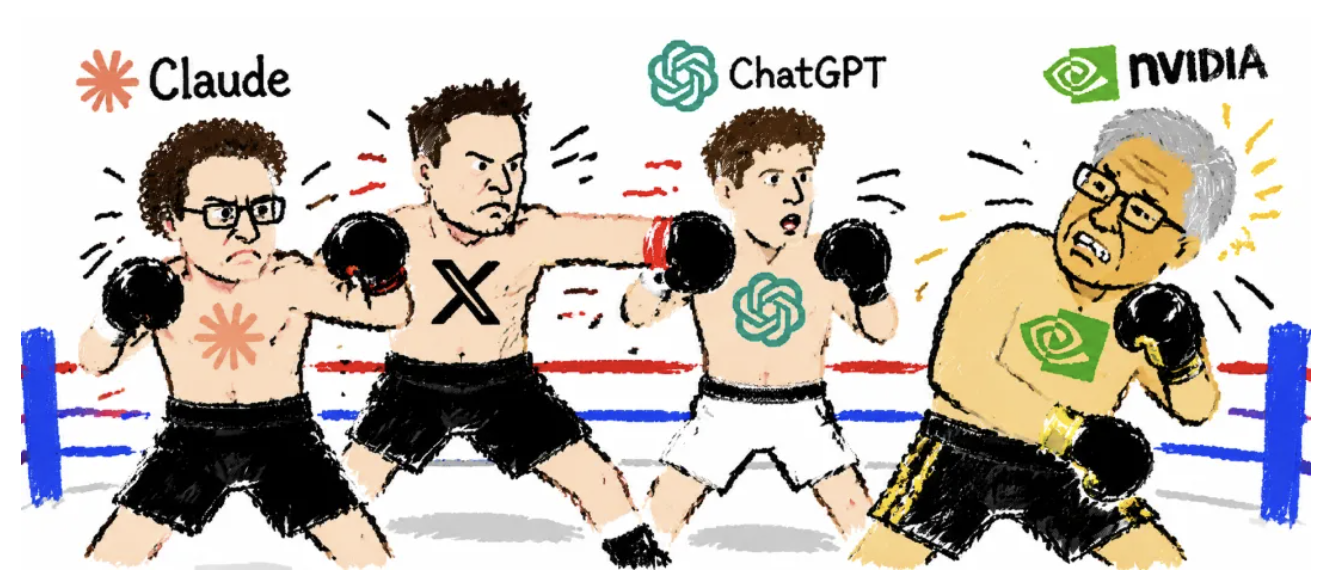
AI 圈最近的热词是 RSI,即递归自我改进。它指 AI 自己写代码、跑实验、改训练流程,再把改进结果传给下一代模型;若循环持续,研发速度可能加快,甚至超过人类理解和控制的速度。安全讨论也随之升温:OpenAI 首席科学家 Jakub Pachocki 把 AI 称为人类尚未充分理解的“异星心智”;Anthropic CEO 达里奥·阿莫代伊警告,更强智能体可能带来大规模网络攻击、失控和文明级风险;黄仁勋则在 All-In 峰会上反驳,不能把安全与创新看成二选一。此前,OpenAI 总裁格雷格·布罗克曼称 GPT-6 Astra 已摸到 AGI 门槛。
RSI 的源头可追溯到 1965 年。英国数学家、密码学家 I.J. Good 设想,如果机器能超越人类智力活动,设计机器也应在它的能力范围内:它能造出更聪明的机器,后者再改进下一代,机器智能由此进入不断加速的正反馈循环,即“智能爆炸”。今天,AGI 关注 AI 能否完成与人类相当的通用认知工作,RSI 更关注 AI 能否改变产生这些能力的系统,让下一轮改进更有效。检查答案只算自我修正;改进研发方法并把有效变化交给后继系统使用,才刚开始触及递归自我改进。
近期,上海交通大学、清华大学、字节跳动、上海人工智能实验室等合作完成的预印本《The Last AI Built by Humans》,将 RSI 自主性分为 L1 至 L5。L1 执行人类方案,L2 自主寻找策略,L3 决定获取哪些经验,L4 把部署反馈转为持续改动;到 L5,改进机制本身也成为改进对象,AI 能修改后续搜索方案、评估结果和组织研究的方式。更激进设想中,AI 还能提出目标、改评估方法、重写底层改进逻辑,成为能继续制造模型的系统。工程上,OpenAI 9 月 6 日内部报告称已实现“自动化研究实习生”目标,截至 8 月中旬,每投入一个人类工作日,其研究部门智能体运行时长相当于 3.1 个工作日;Anthropic 让 Claude 自行查文献、提方案、生成训练数据、运行实验并迭代,实验中 Claude Sonnet 5 帮助早期 Claude Opus 4.8 改善安全表现。