 miranda
非文本模型 Jev 拿到了由 a16z 领投的 8.7 亿美元融资,其公司 TypeSafe 的估值随之升至 75 亿美元。该模型 9 月 15 日发布时,种子轮金额为 4000 万美元,估值约 2 亿,24 天里估值涨了 37 倍。据 Jev 创始人在 X 上公布的信息,产品上线几天用户就突破 100 万,模型推出三周后单日处理数万亿 Token,大约三分之一的财富 500 强企业正在使用。
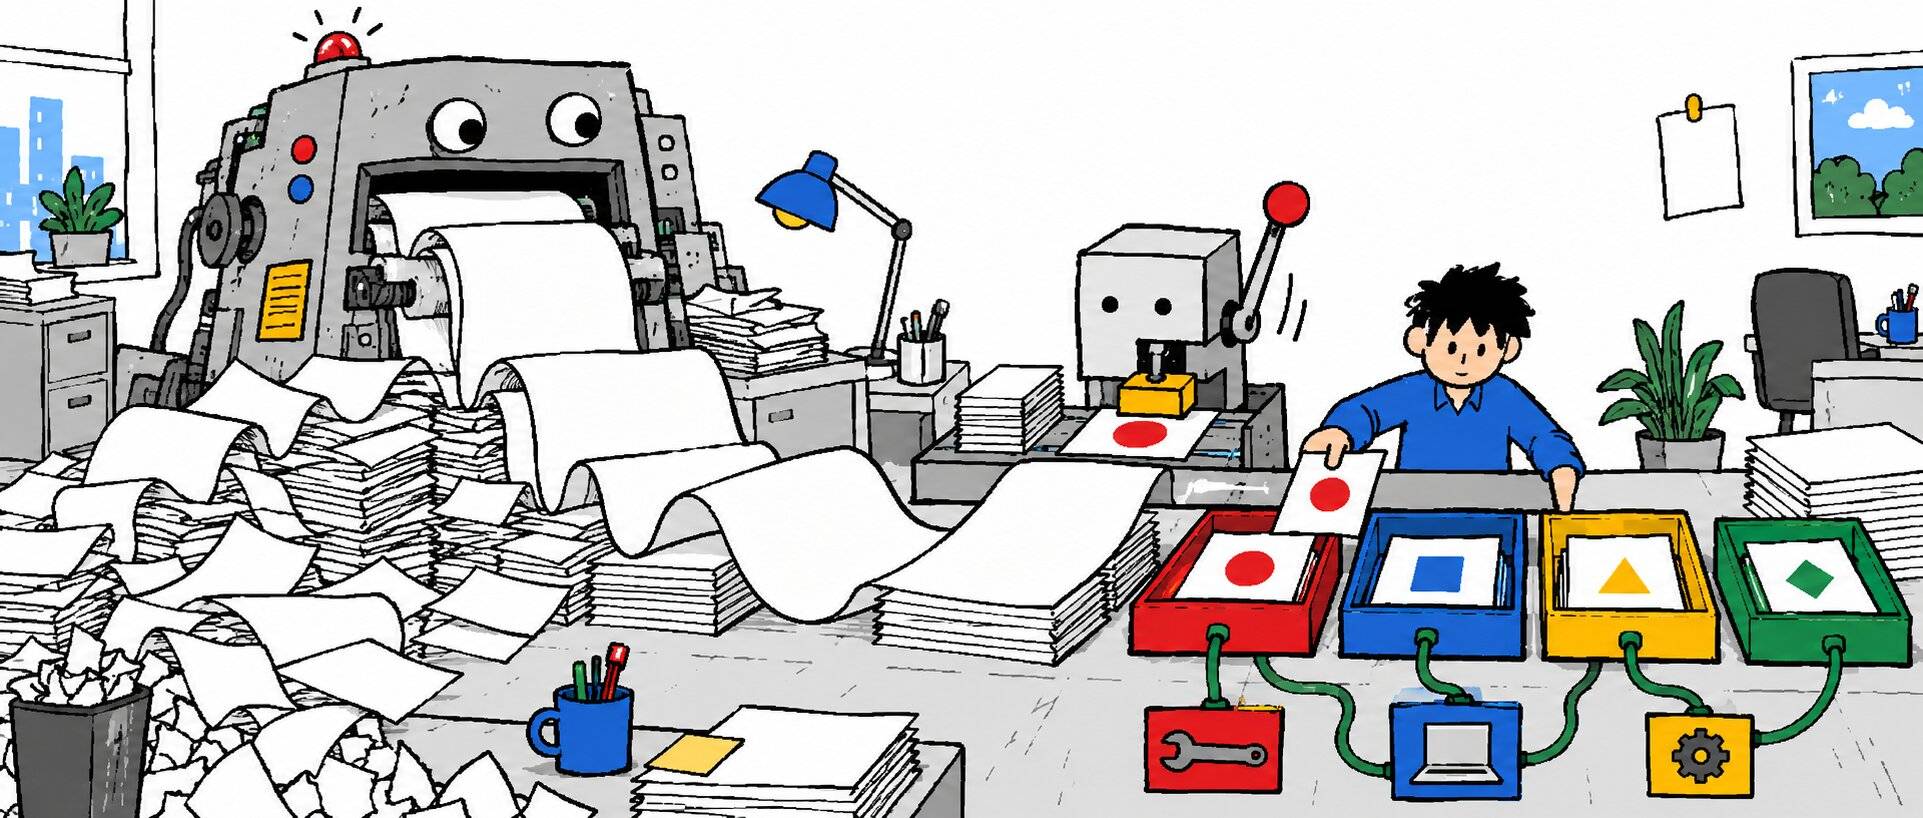
所谓决策模型,不聊天,不写代码,也不总结文档,给它一段上下文和一组预先定义好的候选答案,它返回每个选项的校准概率。它在这个时间点火起来,原因在于 Agent 真的跑起来了。一个 Agent 任务里往往有几十次分支判断:路由到哪个模型、这个工具调用要不要放行、继续还是停止。这类判断答案空间有限、调用量大,又都落在关键路径上;如果每次都交给前沿大模型,延迟会按秒叠加,账单也会随 token 上涨。微软在 Decision-1 的技术博客里也提到,Agentic AI 落地之后,成本成了决定怎么用 AI 的主要因素。
微软发布的 Microsoft-Decision-1 思路相同:输入是一段证据、一个问题、一组固定选项,模型单次前向直接输出每个选项的概率,结果面向程序而非人。比如 Agent 准备调用外部工具时,它可以在“继续执行”“重试”“换工具”“转人工”之间给出概率,应用再按阈值决定下一步:置信度足够高就直接执行,几个选项接近就交给更大的模型,出现“cannot tell”则转人工复核。它支持 yes/no、多选、评分、分类,也能按一套 rubric 给回复或 Agent 动作打分,单次调用最多处理 32K token,输入输出都是文本与 JSON,不生成解释或推理过程。该模型以 Qwen3.5-9B 为基座,由微软继续训练,训练数据来自经过 Microsoft Open Data 流程的公开数据集以及团队生成的合成数据。
按微软技术博客的说法,Decision-1 在 36 个测试集、近 15 万道题中取得最高准确率,速度比 Quyet-1.0-Large 快 4.5 倍,比 GPT-6 Sol 快 35 倍。除了准确率和时延,它更看重校准概率:模型说 90% 把握时,尽量做到真的对 90%,应用才能按阈值把高置信度的判断自动执行,其余转人工或升级大模型。它的角色更像评分器,大模型提方案、写回复,它负责检查条件是否满足、回复能不能交付。这类模型大概率会成为 Agent 基础设施中的一层,但不会取代普通大模型。OpenAI 在开发者大会亮相的 Decisions API 已正式开放公测,由 GPT-6 Luna 驱动,可按文本和图片判断条件成立的概率、从预设选项中作选择,或按指定标准评分,用于投诉分流、图片检查、模型路由和风险筛查等任务;OpenAI 公布的数据显示,相比通过 Responses API 调用同一模型,Decisions API 在特定任务中速度最高可提升 10 倍。