 ice
Google DeepMind 发布了新一代世界模型 Genie 4。与上一代相比,它的单次模拟时长从约一分钟延长到两分钟,画面更逼真,能实时生成声音、模拟物理规律,用户还可以进入 AI 生成的场景,随时改变天气、添加人物,与虚拟角色对话。
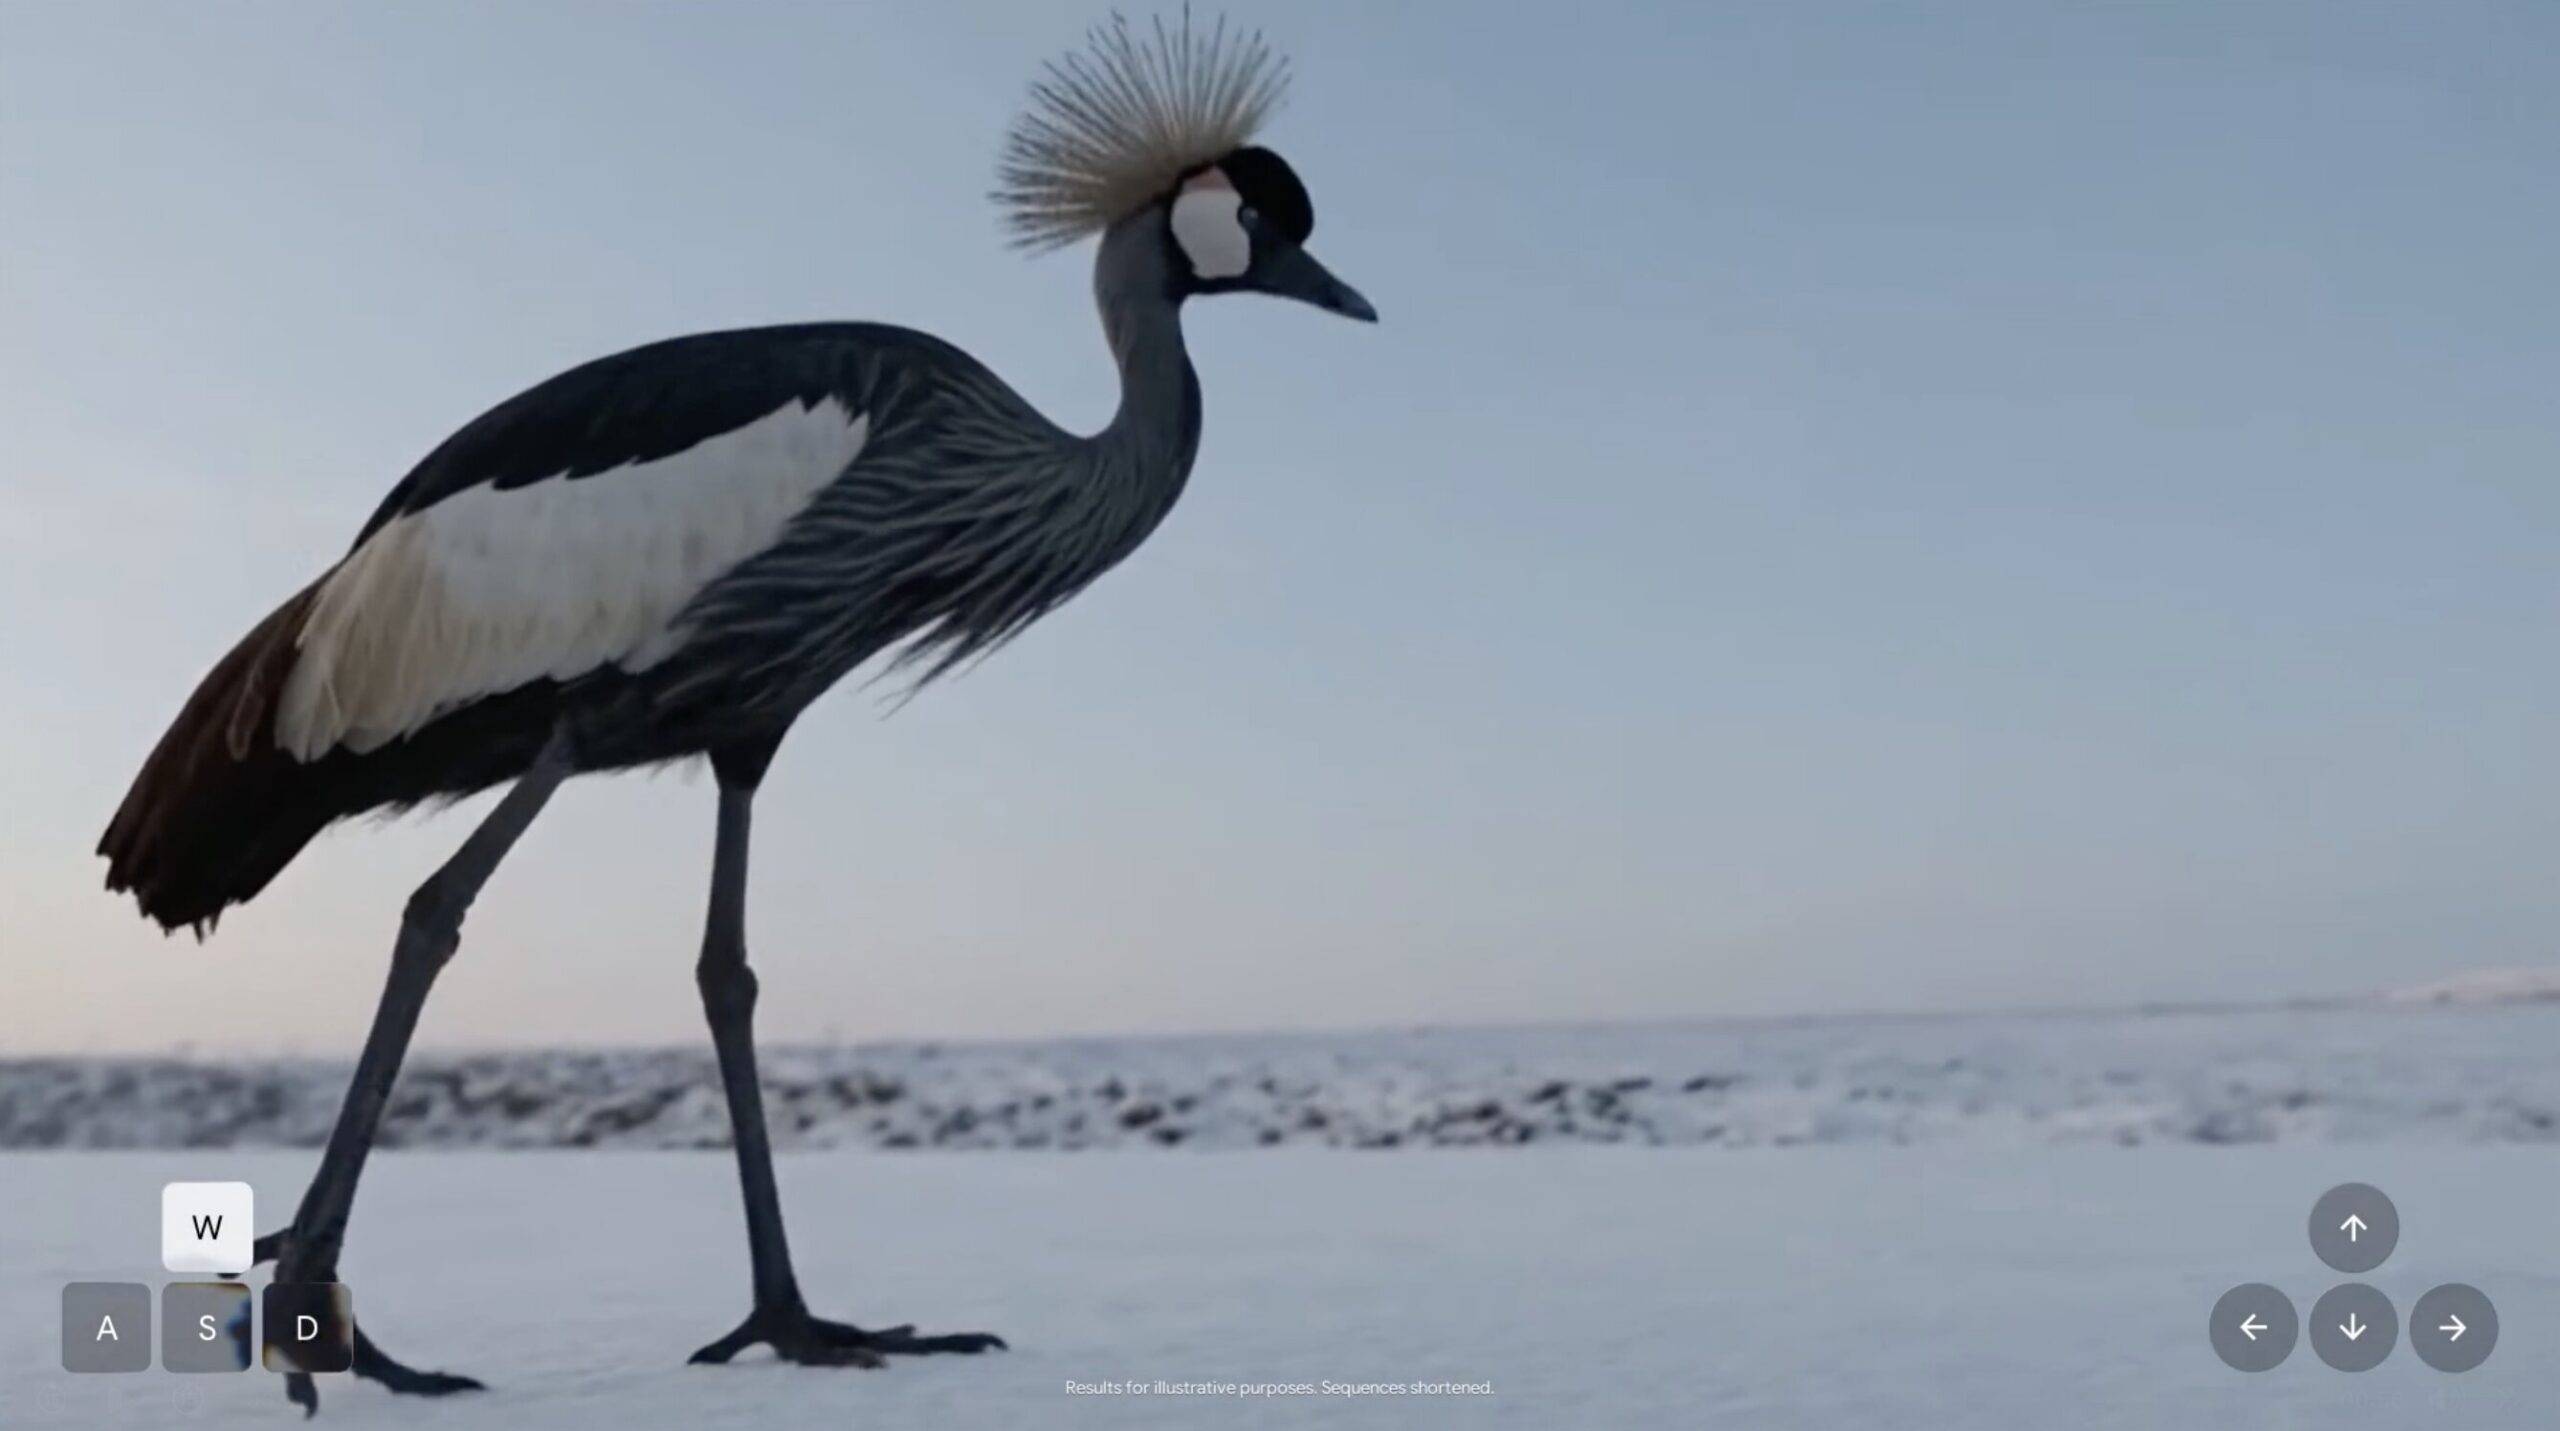
Genie 系列从 2024 年的 Genie 1 起步,最初尝试从视频中学习动作与环境变化之间的关系;Genie 2 将能力扩展到可探索的三维环境;2025 年发布的 Genie 3 实现了实时生成与实时交互。Genie 4 在真实感、物理模拟和交互能力上继续升级。
输入一句话,边玩边改场景
按照谷歌公布的演示,用户输入一段文字即可生成可探索的虚拟世界,用键盘控制角色移动、调整镜头,并在运行过程中继续输入提示词改变场景。演示中有一个漂浮在湖面的小平台,一名穿棕色西装的男子在吹萨克斯,周围是薄雾笼罩的湖水、森林和随风摆动的植物。沃顿商学院教授伊桑·莫利克用一句描述生成了一座虚拟城市,随后实时加入巨龙和一只水獭 NPC;a16z 投资人贾斯汀·摩尔则展示了在 AI 实时生成的城市环境中自由探索的过程。整个过程不需要预先制作三维地图,也没有固定的场景演出。
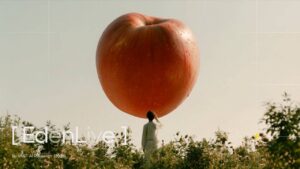
音频是这一代的新增能力。Genie 4 能在生成世界的同时实时生成环境声、音乐和人物对话,例如海浪、风声,以及骑龙穿越山谷时翅膀拍打空气和远处火山活动的声音。虚拟角色的对话也不再依赖预设对白,而是根据用户输入和场景变化动态生成。物理模拟方面,谷歌展示了西瓜受到冲击、枫树种子飘落和拥挤的乡村火车站等案例,涉及碰撞、空气动力学、重力与人群行为。
谷歌还将 Gemini 引入世界模拟,由大语言模型负责规划行动,Genie 4 负责实时生成环境。不过,Genie 4 目前在音频准确性和长期一致性上仍有问题,距离支撑大型开放世界游戏还有不小的技术距离。