 cherry
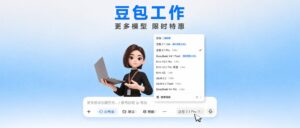
11月12日,豆包工作宣布接入Kimi K3.1 Pro、GLM 5.3、DeepSeek V4.1 Flash等多款第三方模型,用户可以根据任务需要选择不同模型完成工作。平台同时在模型选择页面标注各模型的额度消耗倍率,倍率越低,同等任务消耗的平台额度越少,方便用户把任务需求和成本放在一起权衡。
三款新模型的侧重点并不相同:Kimi K3.1 Pro主打百万字级超长上下文处理,GLM 5.3偏重中文理解与生成,DeepSeek V4.1 Flash则以响应速度和高性价比为主,面向轻量日常任务。加上此前已开放的第三方模型和字节跳动自研的豆包2.1、豆包2.1 Lite,豆包工作的模型矩阵已覆盖高端能力型、均衡通用型和轻量效率型三个层级。
把额度消耗摆到明面上
企业使用大模型时,成本不透明是常见问题。不同模型计费口径不一,有的按输入输出token计算,有的按调用次数收费,用户往往难以预估单个任务的开销。豆包工作此次把各模型的消耗标准统一到同一额度体系下,并在选择页面标注倍率,用户可以直接对比成本,也便于企业做部门级的费用管控。
配合这次更新,平台还推出两项限时优惠:一是在工作日和节假日的指定时段使用活动模型,可享受额度消耗折扣;二是豆包2.1 Lite与DeepSeek V4.1 Flash两款高频轻量模型的消耗倍率限时下调。此外,简单小额任务仍保持免费。豆包工作同时更新了LOGO,豆包形象进入办公场景。