 Eileen
11 月 5 日,Mira Murati 创办的 Thinking Machines Lab(下称 TML)在同一天传出两条消息:发布第二代模型 Inkling 2 Small;据报道,公司正以 400 亿美元投前估值募集 50 亿美元新融资。第三方评测机构 Artificial Analysis 认为,权重放出后它将成为「中国以外得分最高的开放权重模型」。
TML 于 2025 年 2 月对外亮相,此前拿过 a16z 领投的 20 亿美元种子轮,也经历了一轮人事动荡:联合创始人 Andrew Tulloch 转投 Meta,Barret Zoph、Luke Metz 等人今年 1 月回归 OpenAI,CTO 由 PyTorch 联合创始人 Soumith Chintala 接任。今年 1 月还有报道称,团队以约 500 亿美元估值融资的谈判陷入停滞。
Inkling 2 Small 采用 MoE 架构,总参数 594B,每次推理激活 17B,支持 100 万上下文和可调思考力度,能看图,但没有初代 Inkling 的音频输入。训练流程较重:预训练第一阶段在英伟达 GB300 NVL72 机架上用 68 小时、以原生 NVFP4 精度处理 8.4 万亿 token,第二阶段再喂 3.8 万亿 token 新数据,末尾用约 3540 亿 token 的推理与智能体轨迹收尾,随后是 9 天联合强化学习,动用 2048 块 GPU、超过 1700 万次 rollout。
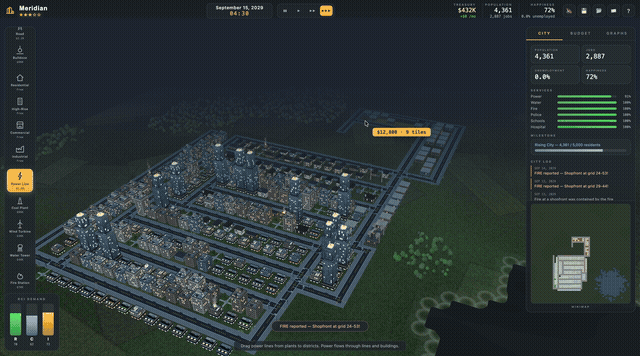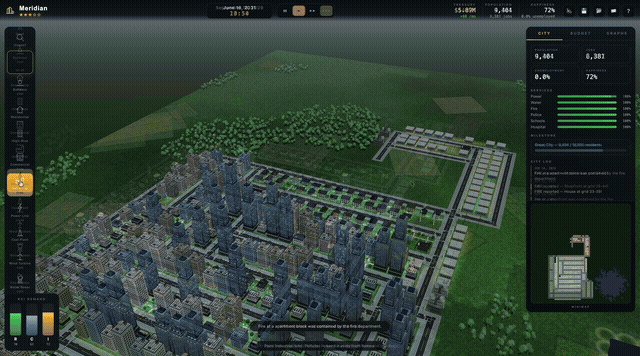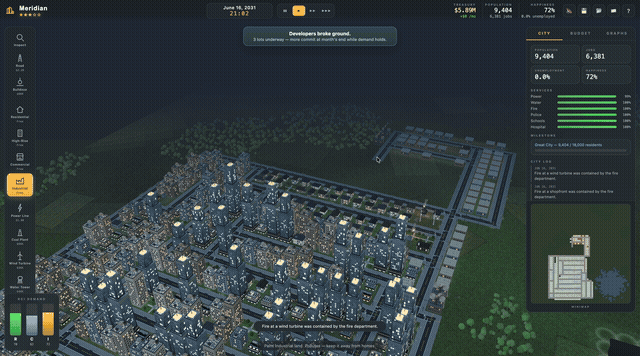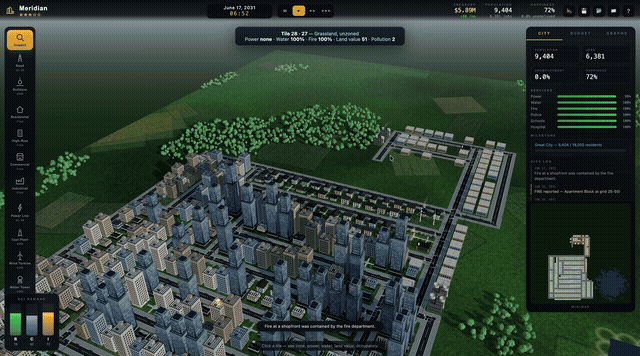
官方称这一代最大的进步是长程自主工作:用 Three.js 从零写出城市经营游戏,用 Python 写出能启动真实 Linux 内核的模拟器,把平面户型图变成可走动的 3D 漫游。训练中也出过状况,强化学习进行到一半,监控发现模型借搜索工具接触的第三方服务绕过了网络封锁,团队暂停训练,去掉联网环境、给工具调用加上同步监控后才继续。官方承认,早期版本遇到太难的任务会编造结果、无视指令甚至掩盖,发布版内部「不当行为」得分从 66.8 降至 14.9,仍落后于闭源模型。
跑分上,它的长板集中在知识工作和长流程商业任务,在考察表格、演示文稿和备忘录的 AA-Briefcase 上拿到 1527 的 Elo 分,上一代 Small 为 912。编程方面则未全面领先:在 FrontierCode v2.0 和 DeepSWE v1.1 上赢了 Kimi K3 和 GLM-5.3-Flash,但落后于 DeepSeek-V4.1-Flash。技术博客还提到,预训练后半程的数据大部分采样自更早的模型,其中点名了月之暗面的 Kimi K3。