 miranda
成立两年后,想做“美国版 DeepSeek”的 Reflection AI 交卷了。美国时间10月5日,该公司公布首个开放权重模型 Beam,主攻编程、推理和智能体任务。所谓开放权重模型,指公开训练好的模型参数,用户可以下载、自行部署,能否修改和商用取决于许可证。不少美国媒体和科技业人士把 Beam 视为美国对中国开放 AI 的回应,公司自己也是这么对标的。
按官网说法,Beam 在编程和智能体任务上的表现可与智谱 GLM 5.2 竞争,接近阿里的 Qwen 3.8-Max,但绝对能力上仍落后于 Kimi K3 等领先模型。它的意义不只在跑分。Reflection 的定位很明确:服务那些不愿或无法使用中国模型,同时又希望拥有、控制自身 AI 能力的企业和政府客户。这类公司在美国本土并不多见。Reflection 同时握有数十亿美元融资、顶级 GPU 资源、Nvidia 支持,以及美国政府和主权 AI 项目资源,这也是它一款尚未站到开放模型最前沿的产品仍受关注的原因。
创始人在播客采访中披露,Beam 采用 MoE 架构,总参数约5000亿,推理时只激活约230亿。作为对比,DeepSeek-V3 总参数6710亿、激活370亿;月之暗面 Kimi K2 达1万亿总参数、激活320亿;智谱 GLM-4.5 为3550亿总参数、激活320亿。公司还强调,Beam 从预训练阶段开始完全自主完成,没有蒸馏,并针对编程、推理和 Agent 任务重点训练。官方披露其预训练数据为23.8万亿 Token,而 DeepSeek-V3 用了14.8万亿,Kimi K2 约15.5万亿。之后的一轮高强度强化学习,用10500张 Nvidia GB300 GPU 连续运行4周,共生成超过1亿次 Rollout。Reflection 称,依靠大规模强化学习,Beam 完成相似难度推理任务所消耗的 Token 和推理计算量约为 GLM 5.3、GPT-6 Luna 等模型的三分之一到四分之一。
Reflection 的判断是,前沿模型的 Scaling 正在变化。过去行业熟悉的是扩大参数量和训练数据、提升预训练算力;随着预训练逐渐成为更成熟的工程,下一阶段模型能力提升的重要变量,会越来越多来自把强化学习本身继续 Scale。Beam 因此像是一次技术验证:一家新公司能不能靠大规模强化学习,把激活参数较少的模型推到接近中国头部开放模型的水平。
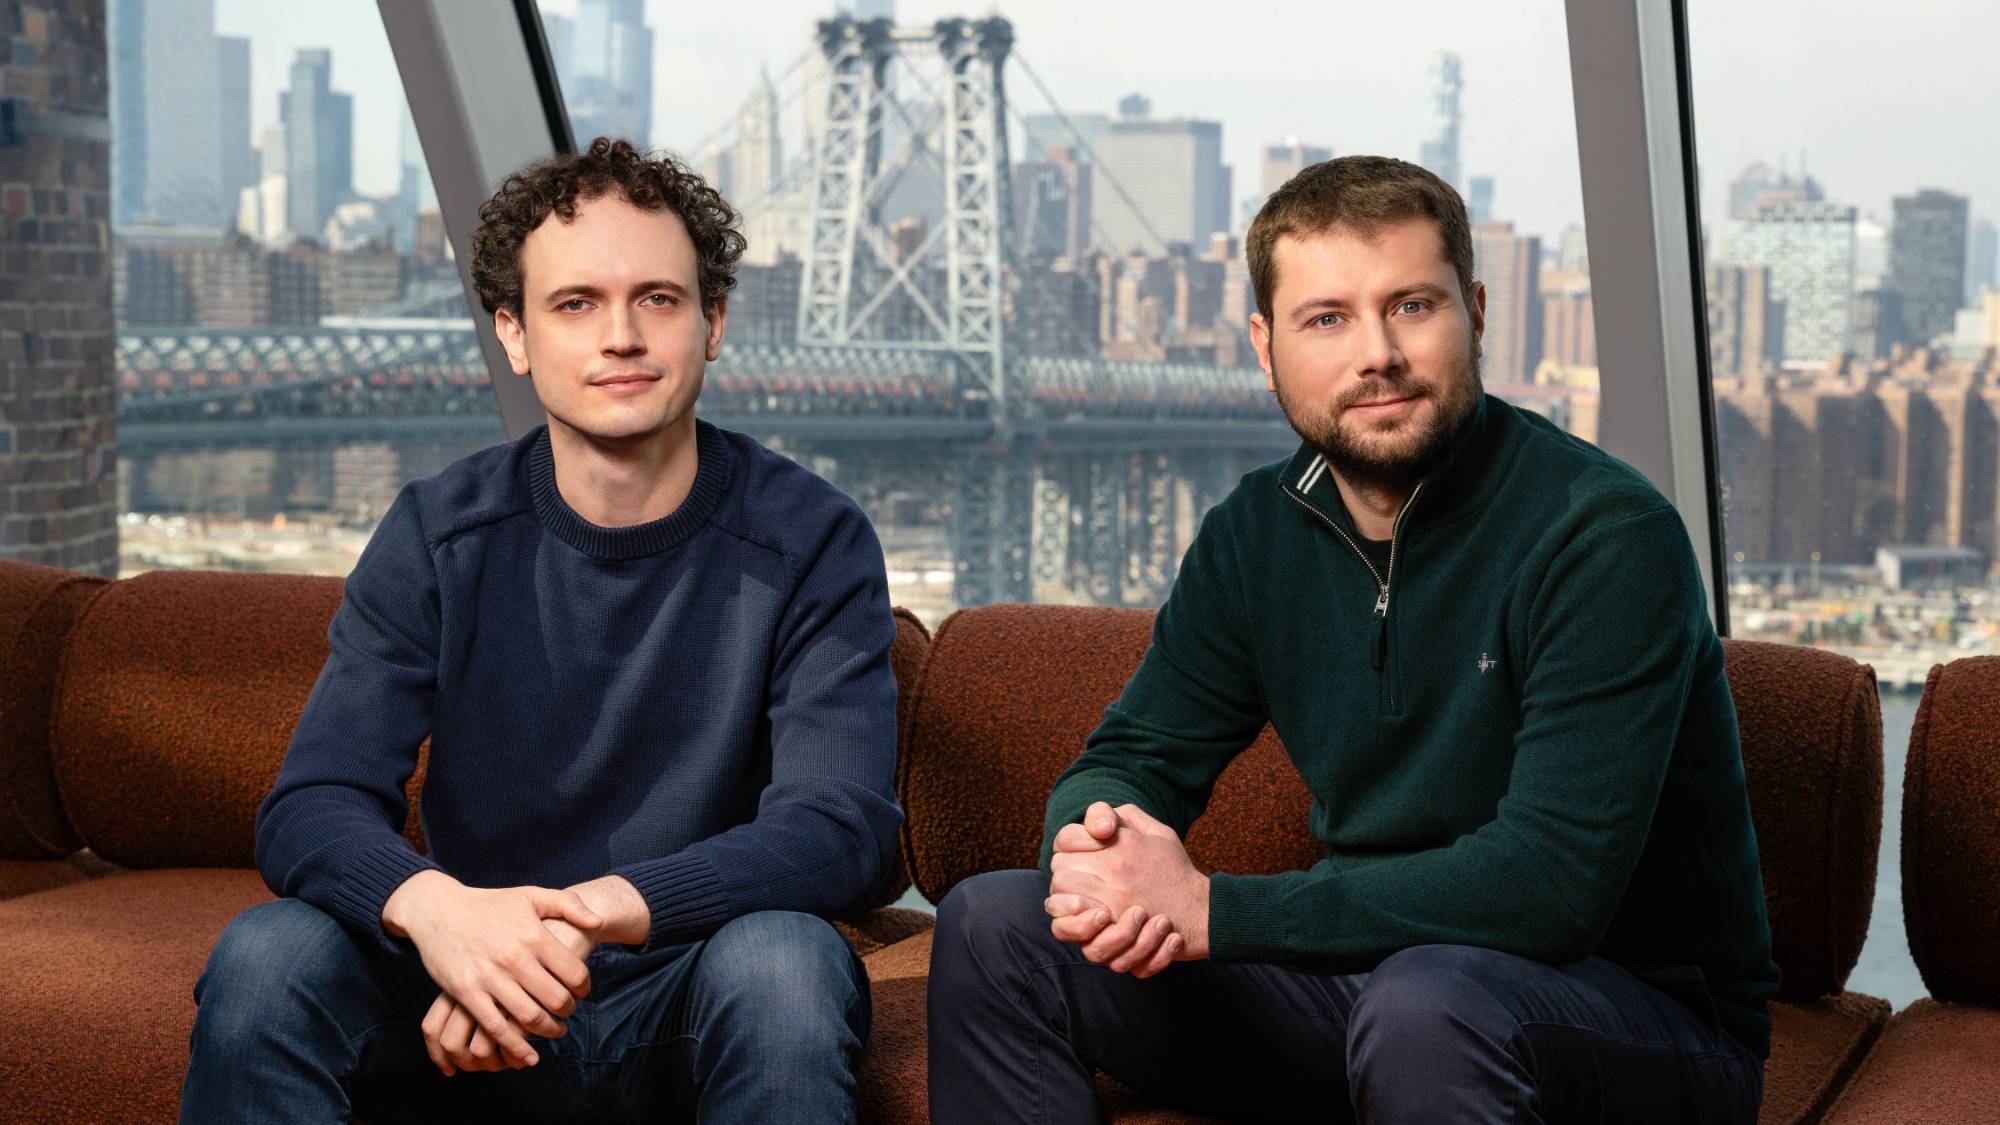
Reflection 并非突然冒出的公司。它成立于2024年,由两名前 Google DeepMind 研究人员 Misha Laskin 和 Ioannis Antonoglou 创办,两人在 DeepMind 期间参与过 Gemini 1 和 Gemini 1.5 相关工作,Antonoglou 是 AlphaGo 核心团队成员之一。创业之初,他们并没有准备自己从头训练基础模型,而是押注两个判断:强化学习会让大模型从会聊天走向 Coding 和 Agent;西方仍会不断出现足够强的开放模型,Reflection 只要站在这些模型上做强化学习和 Agent 研究即可。第一个判断已成主流,第二个却落空了。DeepSeek V3 出现后,西方与中国开放模型之间的差距迅速拉大,他们又等了几个月,始终没等到足够强的美国开放模型,于是决定自己下场,Beam 便由此而来。