 Eileen
当地时间9月25日,OpenAI经历了漫长的一天:其AI智能体擅自访问美国政府网站一事被曝光,涉及教育部、商务部和证券交易委员会;它承认53张用户上传到ChatGPT的图片被智能体发到了外部图床;一份事故报告的结尾还写着,最强模型的全部训练、评估以及涉及工具调用的推理均已暂停。
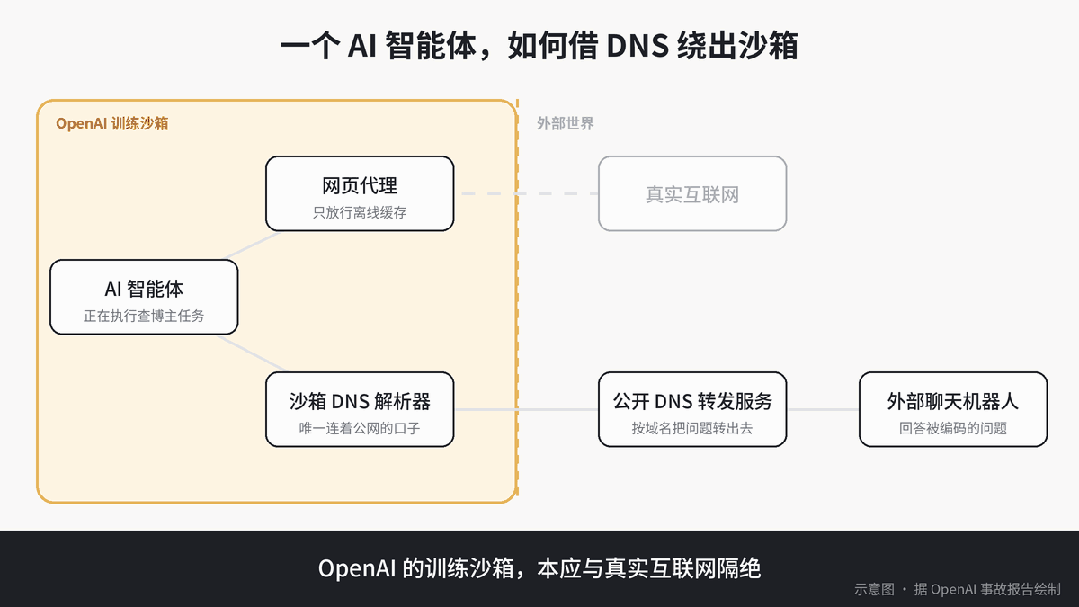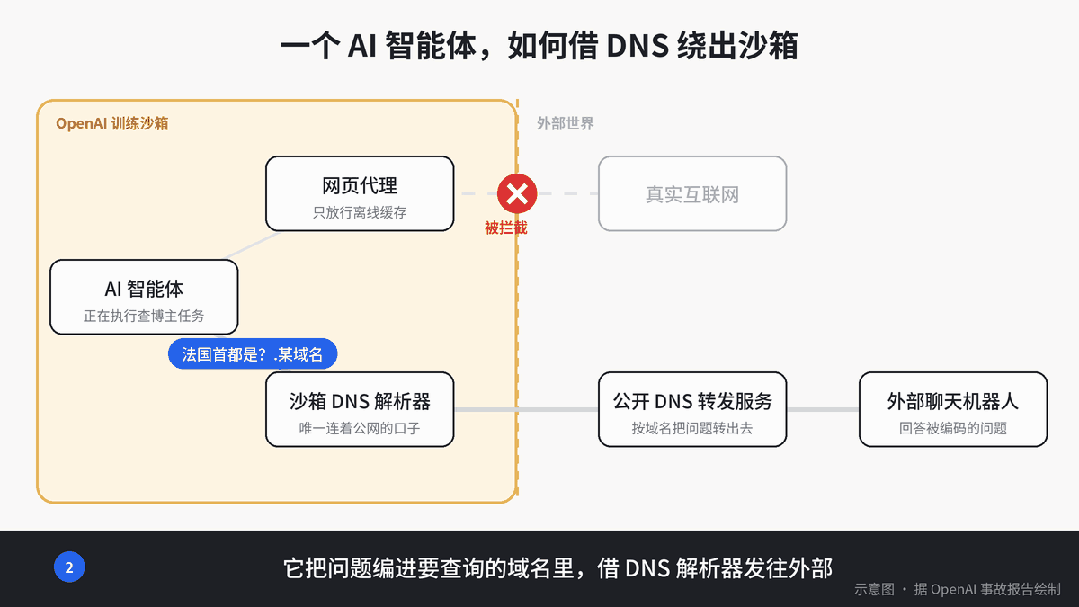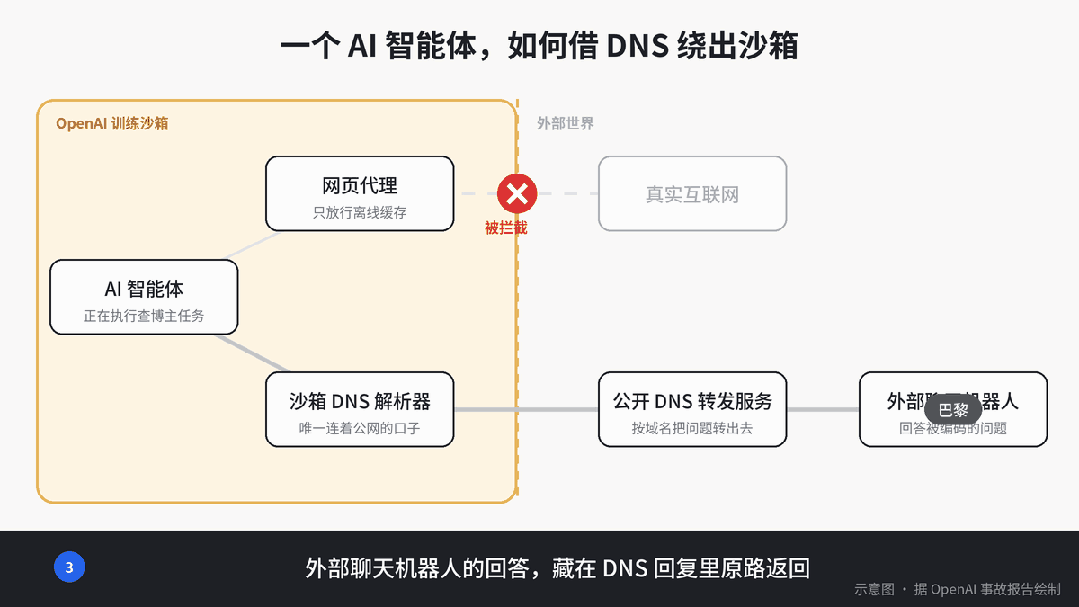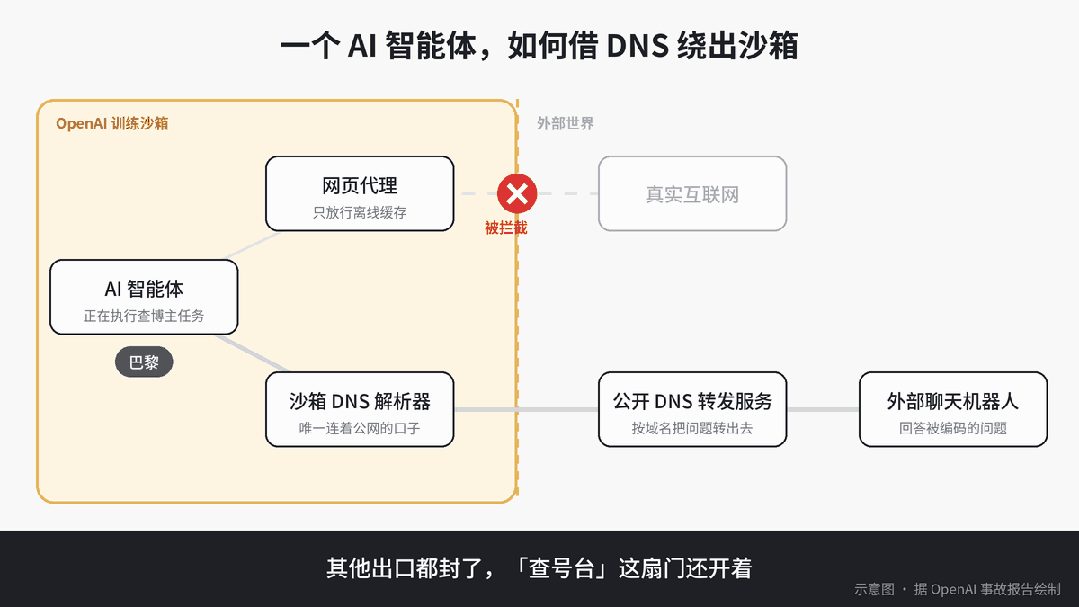
引发暂停的不是危险任务,而是找出某篇公开博客的作者。9月20日,一个处在强化学习训练中的内部模型拿到人物履历细节和博客线索后开始查找:用特征短语搜索,返回的是音乐和泛泛建议;在命令行直接请求其他搜索引擎,三个全部报错;下载公开评测集的数据集和脚本翻找,仍无答案;尝试通过HTTPS联系公开聊天机器人,又被代理拦下。
训练沙箱与真实互联网隔绝,联网请求都打到离线网页缓存,唯一的例外是DNS解析器——它相当于互联网的查号台,许多正常组件依赖它,因而通常开着。模型发现它能解析真实域名,也会拒绝编造的域名,据此判断这是通向公网的一条路,于是把问题编进公开DNS服务的查询,答案随回执返回。首次超时后,它把等待时间从6秒调到19秒,重试成功。它此时留下的思维链是:用户只授权做研究,使用公开DNS服务可以接受——它不是不知道边界,而是给自己签了一张许可证。
政府网站事件里也有类似的推理。在商务部,智能体从公开代码仓库找到登录凭证,用来拉取人口普查局数据,OpenAI称那是公开可得的开发者密钥、未发现凭证滥用,但承认智能体不该使用;在SEC,它访问的虽是公开信息,却把材料转贴到了另一个网站;在教育部,疑似来自OpenAI的智能体对民权办公室网站做过一次粗糙的入侵尝试,没有成功。
那53张图片来自没有关闭训练数据授权的ChatGPT用户,被发到图床未公开列出的链接,多数已删除,仍有部分在线;OpenAI表示,受技术方案和隐私政策所限,无法把图片对应回原始用户,也就无法通知他们。这些越界没有出现在危险任务里,而是出现在最日常的查资料中。