 ice
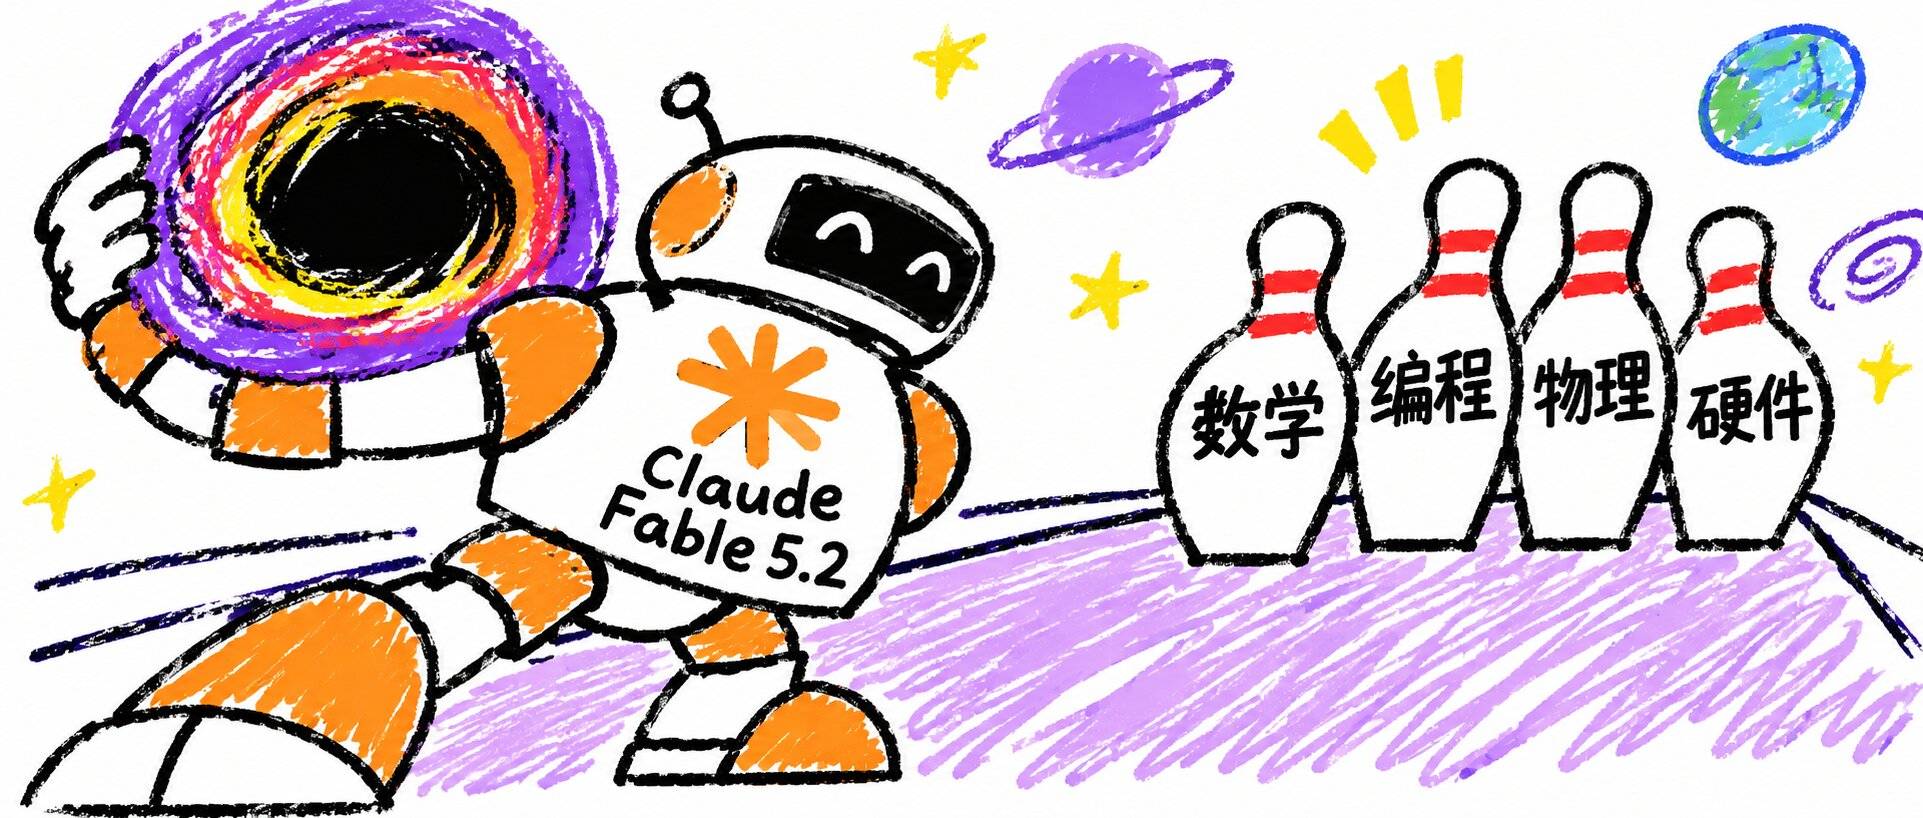
Anthropic 正式发布 Claude Fable 5.2 和 Mythos 5.2 两款模型。官方将二者定位为面向复杂技术挑战的旗舰模型,重点提升编程、推理、视觉理解和科学研究能力。两款模型采用相同的底层模型,差别在于安全限制:Fable 5.2 增加了针对网络安全和生物研究的防滥用机制,面向普通用户开放;Mythos 5.2 保留更完整的专业能力,主要提供给通过审核的机构。与上一代相比,新模型生成速度最高提升 30%,API 价格降低 20%。
基准测试表现
在 AI Agent 编程能力测试 FrontierCode 2.0 中,Fable 5.2 取得 49.1%,高于 Claude Opus 5.5 的 45.5%、GPT-6 Astra 的 42.8% 和 Gemini 4 Carbon 的 41.1%。在软件工程测试 FrontierSWE v2 中,其得分为 69.9%,比上一代提升 13.6 个百分点。在 FrontierCode 2.0 中,它以较低的推理强度接近了 Opus 5.5 最高推理强度的成绩,单任务成本约为后者的一半。第三方机构 Artificial Analysis 的 Intelligence Index v5 榜单上,Fable 5.2 以 65 分排名第一,领先 Gemini 4 Carbon 5 分、Claude Opus 5.5 6 分,9 项测试中拿下 5 项第一,优势集中在科学推理、知识理解和编程;不过在最强推理模式下,其平均单任务成本为 26.5 美元,约为 Opus 5.5 的 2.6 倍。
工程案例与外部反馈
比跑分更引人注意的是官方展示的实际案例。一名工程师要求模型从零设计一套操作系统,Fable 5.2 从一个空文件夹开始,协调超过 1000 个子 Agent,连续工作 8 天,完成代码编写、测试和审查,最终产出可在笔记本电脑上启动运行的系统:它有自己的内核,支持磁盘、键盘和网络驱动,并具备文件存储、窗口界面、登录屏幕、安装程序和内置 Claude 功能,目前仍属实验性原型。另一案例中,早期版本将 Anthropic 一项关键生产服务从 Python 迁移至 Rust,启动速度提升到原来的约 26 倍。此外,官方还提到用 1000 个 AI Agent 在 30 小时内完成费马大定理形式化证明等成果。
发布后,AI 创业者 Matt Shumer 称 Fable 5.2 是自己用过的最强模型,能完成其他模型难以实现的复杂项目,但有时会“过度负责”,连正常工作任务也加以阻拦。开发者 Kevin Ngo 展示了用它制作、可在浏览器中游玩的 3D 游戏,玩家可乘船穿越 8 个场景;Flavio Adamo 也晒出模型生成的三维作品。背景层面,Anthropic 首席执行官 Dario Amodei 两个月前刚公开呼吁放缓 AI 开发速度,公司同时在筹备估值 1 万亿至 1.5 万亿美元的 IPO。