 Eileen
通过第三方API、聚合平台或中转服务调用模型的用户,往往很难确认后台运行的究竟是不是标价对应的那个模型。一次请求要经过用户、中转站、上游服务商、模型等多个环节,只要其中一环不够透明,用户就无法判断自己拿到的是旗舰模型,还是被换成了更便宜的小模型或旧模型。
这个问题已有实测数据。斯坦福大学的Model Equality Testing项目曾测试2024年四款Llama模型的31个商业API端点,发现其中11个端点的输出分布,与Meta发布权重的参考分布存在统计差异。也就是说,同一个模型名字,有时并不对应同一种表现。
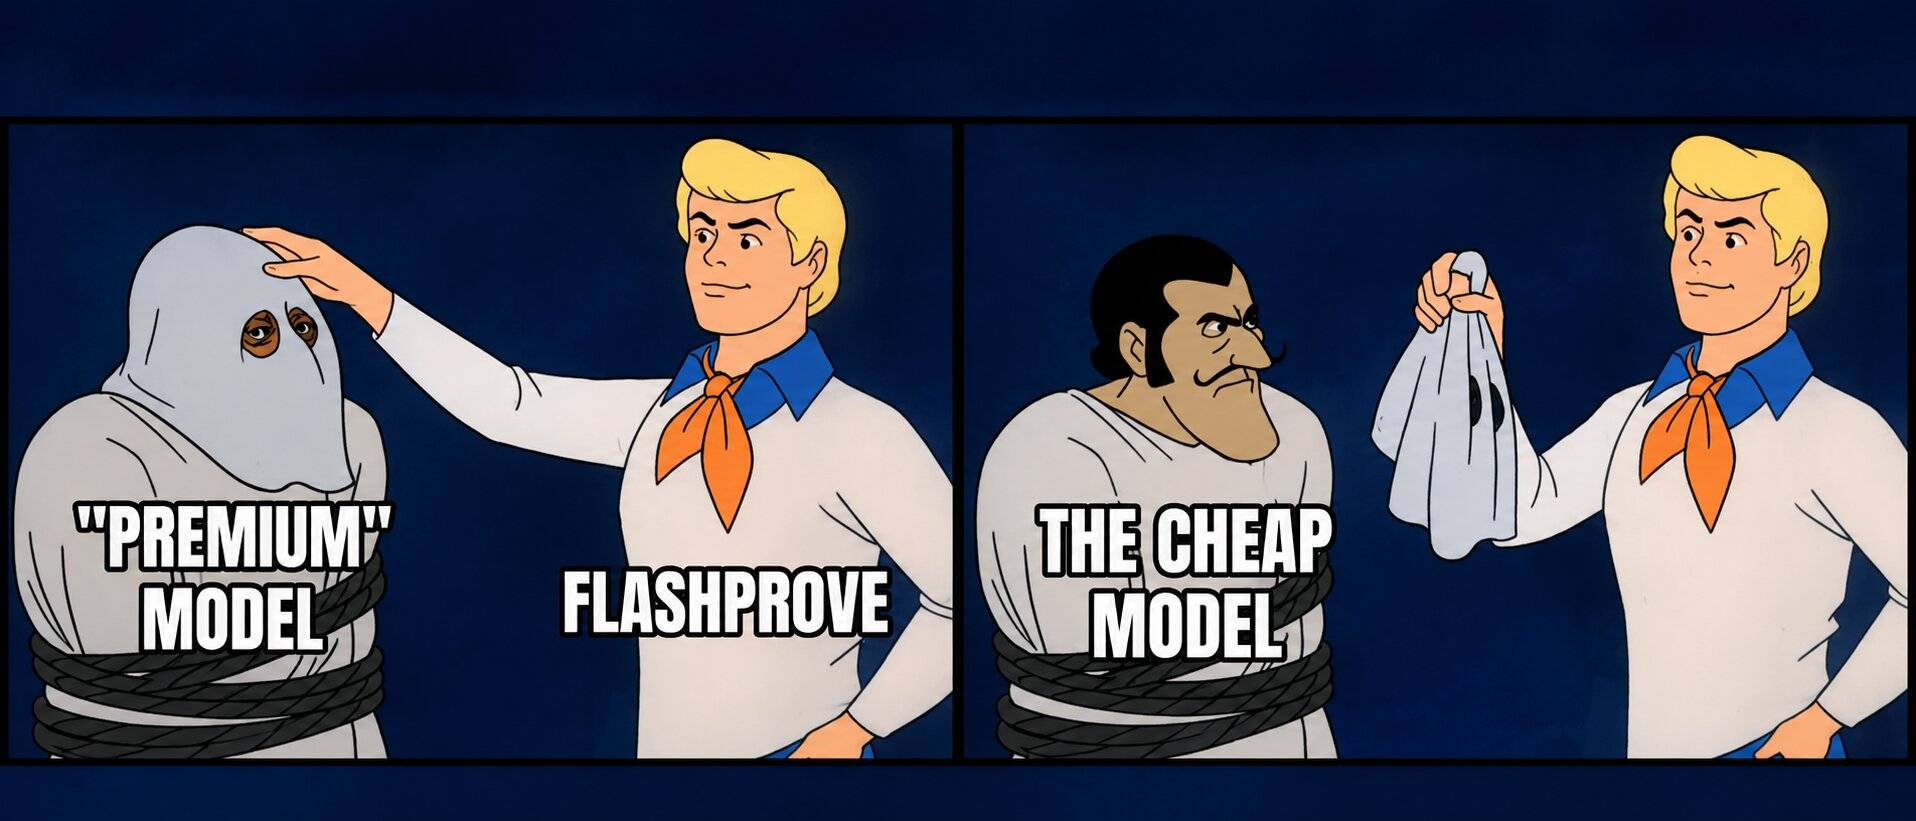
Anthropic近日发布的开源研究原型FlashProve,尝试把这件事变成可以验证的问题。其核心是zkSNARK零知识证明:服务商先为模型权重生成一个“承诺”,即一组能够锁定特定权重、但不公开权重本身的密码学指纹;再针对给定输入与待检查输出生成证明。用户拿到模型承诺、提示词、回答和证明文件后,可在自己的电脑上核验这套权重处理该输入时是否确实会产生这些输出。若中途换了模型或改动了输出,证明就无法与原来的承诺对应。零知识的设计还保证验证者不会因此获得权重、中间计算值,以及MoE模型在各层调用了哪些专家。
实验使用公开4-bit权重的Llama 4 Maverick,该模型拥有4000亿参数的混合专家模型,每个token实际激活约170亿参数。Anthropic公布的数据是:单张H100生成证明的吞吐量约110 tokens/秒;每个1024-token请求的证明约19MB;验证不需要GPU,24线程CPU约需17秒,单线程约需21秒;权重的初始承诺只需生成一次,耗时约39分钟。需要说明的是,110 tokens/秒是证明生成速度,不是聊天时的模型输出速度;在Anthropic的对比条件下,生成证明的GPU时间约为普通vLLM推理的70至95倍。