 cherry
记忆张量发布并开源了记忆原生大模型MemT 1.0。它与常见外挂检索方案的区别在于,记忆不再作为外部模块调用,而是被纳入底层架构,并通过训练让模型学习读写、更新和调用记忆,使经验积累成为模型能力的一部分。
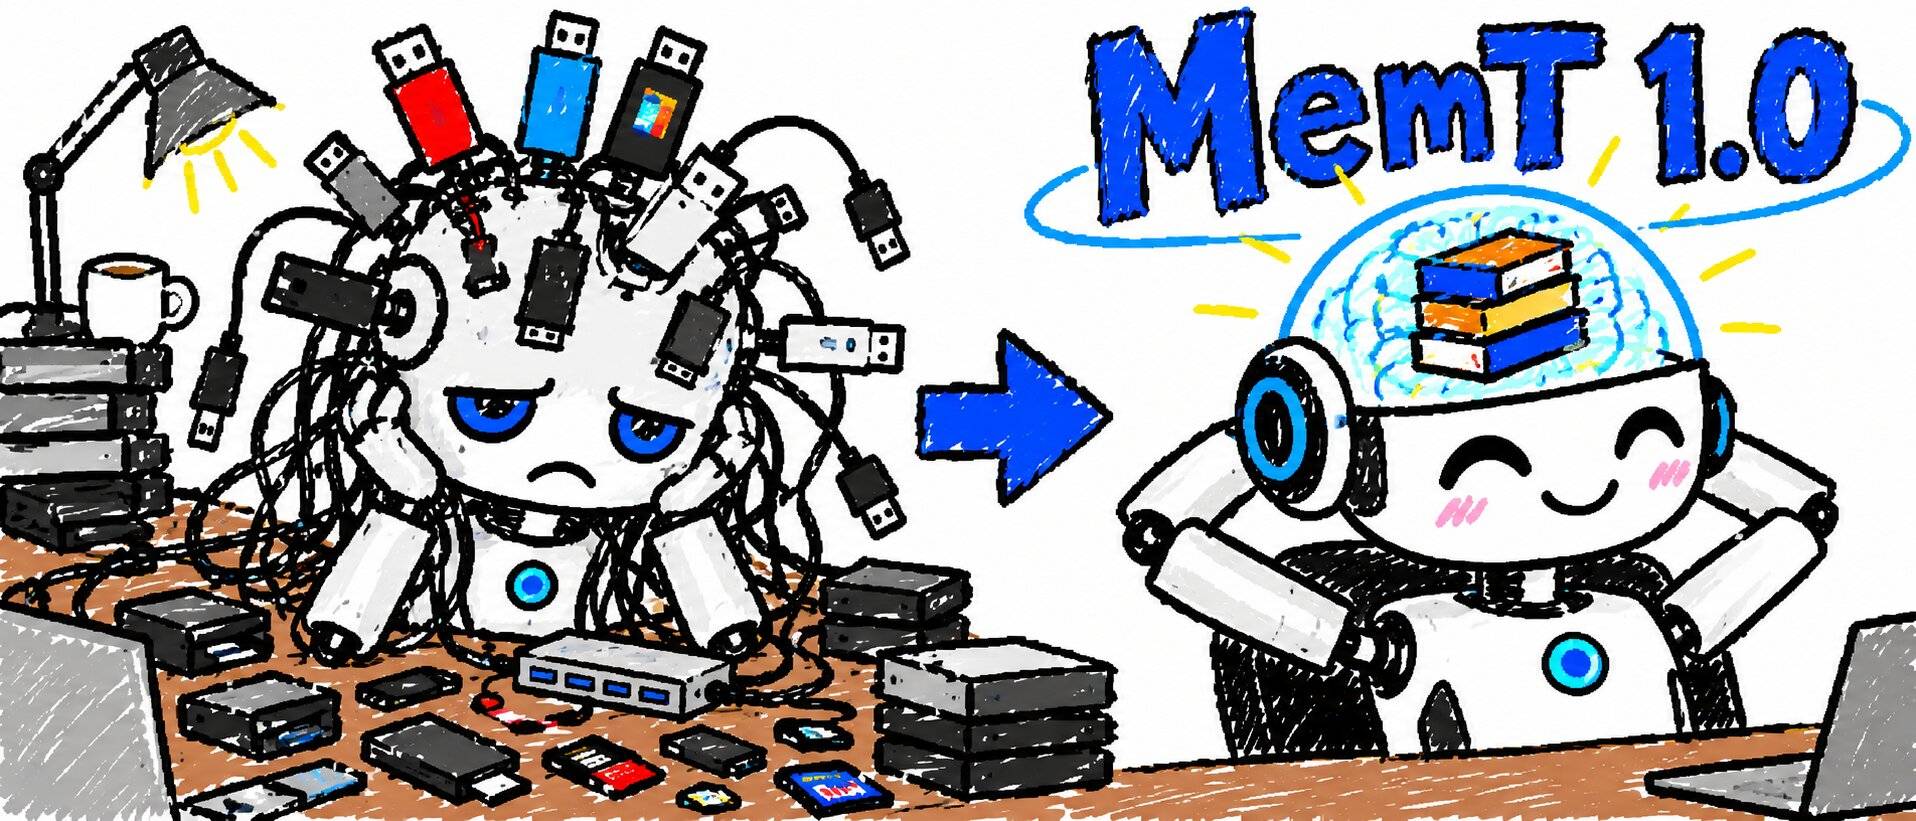
架构上,MemT 1.0将模型能力分为主干网络和动态记忆状态。主干网络承担通用认知,动态记忆状态在不同用户或任务之间彼此独立,并在持续交互中吸收新信息,直接参与后续每一轮生成计算。每轮对话结束时,模型通过token级更新机制刷新记忆状态,哪些保留、哪些修改由训练得到的门控机制决定。后续对话和任务中,并行记忆注意力机制会提取这些状态,参与当前计算并引导下一步决策。
训练使用了340亿token数据,分两步进行:先用200亿token做继续预训练,让模型尝试用过去片段预测未来;再用140亿token做后训练,由教师模型对记忆提取打分。记忆状态采用固定体积,持续交互只更新已有矩阵。Mixture-of-Storage架构中,基座MoE负责计算,多位记忆专家分担存储空间的读写分配。
在11项系统记忆基准测试中,测试覆盖长期保留、动态更新、个性化理解等维度,历史跨度从16K直至百万token。闭卷作答的MemT-1.0-Flash和MemT-1.0-Nano均分分别为50.6和47.0,分别领先同组最强参数化记忆基线12.5分和8.9分。消融实验显示,拿掉后训练后Nano均分从47.0降至36.3;MoS记忆专家从2个增至4个,均分最高提升2.7分。测试还显示,在约16K token的历史中,用户未提供生日时模型回答不知道;在五百多轮、约6.6万token的展览改期对话后,模型仍能区分周日定论与周一备选,并指出场地、票价和联系人未变。